انبار داده یکی از مفاهیم بنیادین دنیای فناوری اطلاعات و هوش تجاری است که به سازمانها کمک میکند دادههای پراکنده خود را یکجا جمع کنند، آنها را یکپارچه و تمیز سازند و در اختیار تحلیلگران و مدیران قرار دهند تا بتوانند گزارشهای دقیق و تصمیمهای راهبردی بگیرند. در این مقاله جامع و کامل، به زبان ساده اما دقیق توضیح میدهیم که انبار داده چیست، چه اجزایی دارد، فرآیند ETL چگونه انجام میشود، چه معماریهایی برای آن وجود دارد، چه ابزارهایی برای پیادهسازی آن استفاده میشود و چگونه میتوان آن را در سازمان پیادهسازی کرد.
همچنین مزایا، چالشها، امنیت، حاکمیت داده و کاربردهای واقعی آن در صنایع مختلف مانند خردهفروشی، بانکداری، درمان، بازاریابی، حملونقل و تولید را بررسی میکنیم. اگر به دنبال یک راهنمای کامل و کاربردی برای درک این فناوری از صفر تا صد هستید و میخواهید بدانید چگونه میتواند به رشد و توسعه کسبوکار شما کمک کند، این مقاله را از دست ندهید.
فهرست محتوا
انبار داده را بشناسید
تصور کنید یک فروشگاه اینترنتی بزرگ دارید. هر روز هزاران سفارش ثبت میشود، مشتریها نظرات خود را مینویسند، پرداختها انجام میشود و انبار محصولات مدام تغییر میکند. حالا اگر بخواهید بدانید «چرا فروش این ماه نسبت به ماه قبل کم شده؟» یا «کدام دسته از محصولات بیشترین سود را دارند؟» باید به کجا مراجعه کنید؟ پاسخ ساده است: انبار داده.
انبار داده (Data Warehouse) یکی از مفاهیم بنیادین دنیای فناوری اطلاعات و هوش تجاری است که به سازمانها کمک میکند دادههای پراکنده خود را یکجا جمع کنند، آنها را تحلیل نمایند و بر اساس آنها تصمیمهای هوشمندانه بگیرند. در این مقاله قصد داریم به زبان ساده اما دقیق و کامل توضیح دهیم که انبار داده چیست، چه کاربردی دارد، چگونه کار میکند، چه اجزایی دارد، چه مزایا و چالشهایی دارد و چرا امروزه به یکی از ضروریترین ابزارهای هر کسبوکار تبدیل شده است. هدف این است که حتی اگر هیچ اطلاعاتی از این موضوع ندارید، پس از خواندن این مقاله درک کاملی از انبار داده پیدا کنید.
انبار داده چیست؟
انبار داده نوعی سیستم مدیریت داده است که برای پشتیبانی از هوش تجاری (Business Intelligence) و تجزیهوتحلیل دادهها طراحی شده است. برخلاف پایگاههای داده معمولی که برای ثبت و پردازش تراکنشهای روزانه استفاده میشوند، انبار داده برای ذخیرهسازی حجم عظیمی از دادههای تاریخی و انجام تحلیلهای پیچیده ساخته شده است.
به بیان سادهتر، انبار داده مانند یک مخزن بزرگ است که دادهها را از منابع مختلف جمعآوری میکند، آنها را یکپارچه و تمیز میسازد و در اختیار تحلیلگران و مدیران قرار میدهد تا بتوانند گزارشهای دقیق و تصمیمهای راهبردی بگیرند.
انبار داده معمولاً مقادیر زیادی از اطلاعات تاریخی را در خود جای میدهد. این اطلاعات از منابع گوناگونی مانند فایلهای گزارش، سیستمهای تراکنشی، برنامههای کاربردی و پایگاههای داده عملیاتی جمعآوری میشوند. سپس انبار داده با استفاده از قابلیتهای تحلیلی خود به سازمان اجازه میدهد تا اطلاعات تجاری ارزشمندی را برای بهبود تصمیمگیری استخراج کند. این سیستم در طول بازههای زمانی مختلف رکوردهای متنوعی را ایجاد میکند. این رکوردها برای دانشمندان داده و تحلیلگران بازارهای مالی اهمیت زیادی خواهند داشت.
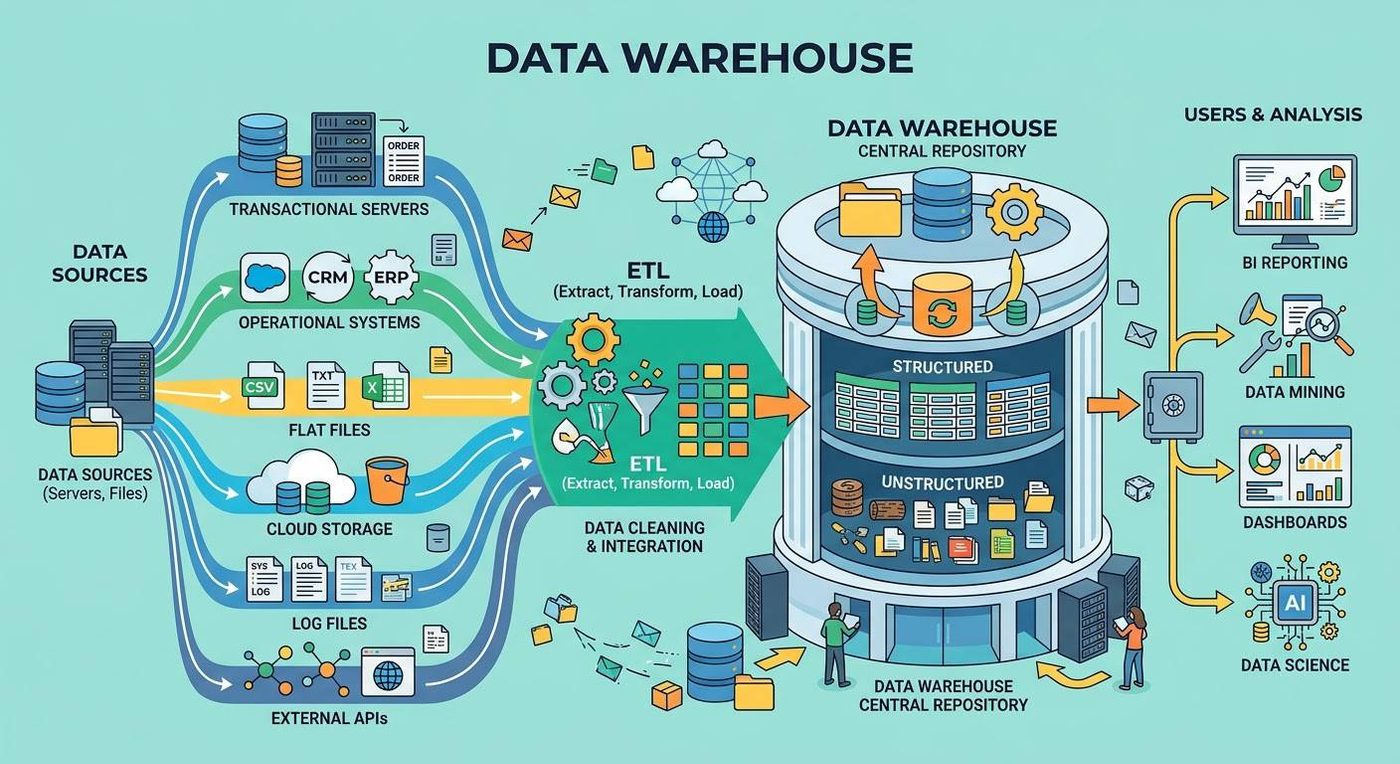
برای درک بهتر، بیایید یک مثال واقعی بزنیم. فرض کنید یک بانک بزرگ را در نظر بگیرید. این بانک دارای سیستمهای مختلفی است: یکی برای ثبت تراکنشهای مشتریان، یکی برای مدیریت حسابها، یکی برای وامها و یکی برای خدمات اینترنتی. هر کدام از این سیستمها دادههای خود را جداگانه ذخیره میکنند. حالا اگر مدیرعامل بانک بخواهد بداند «کدام مشتریان هم وام دارند، هم حساب پسانداز و هم از خدمات اینترنتی استفاده میکنند؟» بدون انبار داده پاسخ به این سؤال تقریباً غیرممکن است. اما با انبار داده، تمام این دادهها یکجا جمع شده و تحلیل آنها به سادگی انجام میشود.
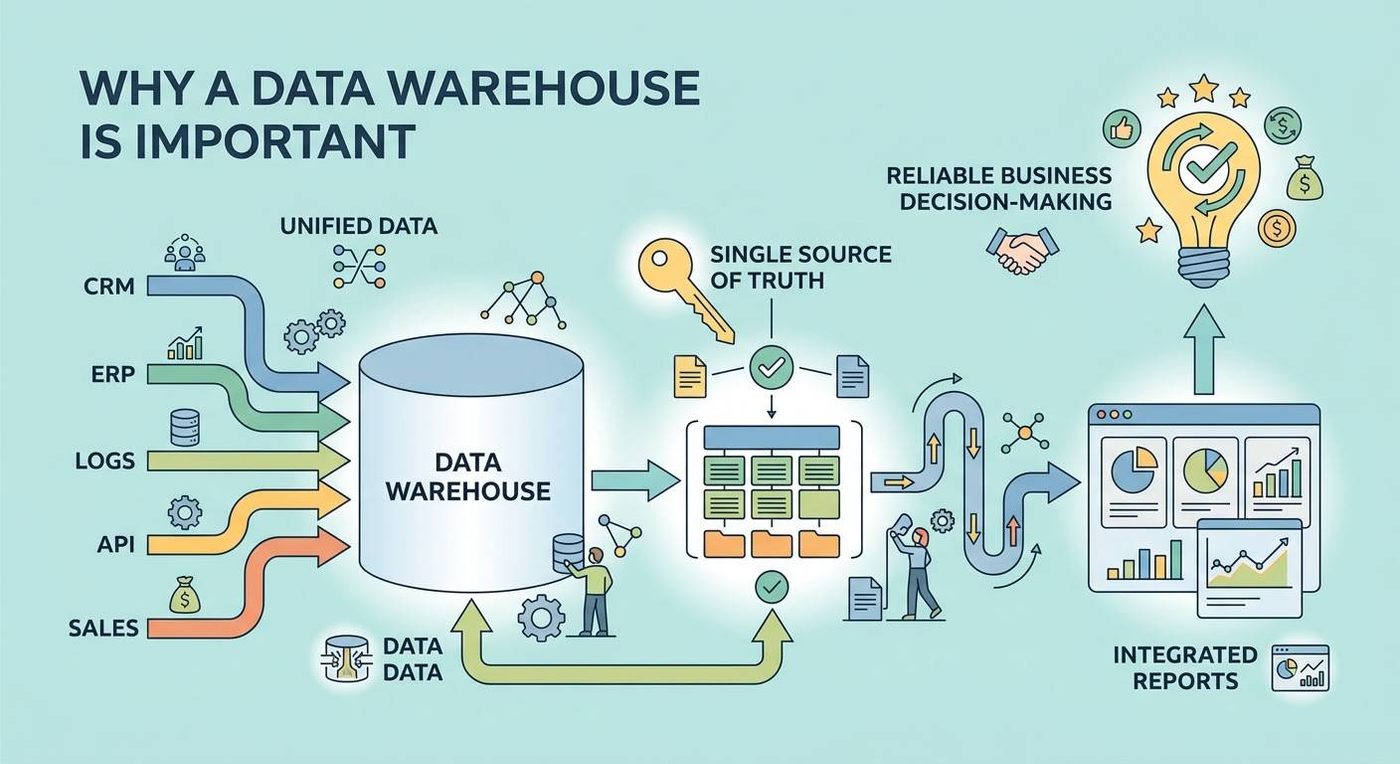
نکته مهم این است که انبار داده فقط یک پایگاه داده بزرگ نیست. بلکه یک سیستم کامل است که شامل فرآیندهای استخراج، تبدیل، بارگذاری، ذخیرهسازی و تحلیل داده میشود. انبار داده به عنوان «واحد حقیقت» یک سازمان شناخته میشود. یعنی همه افراد سازمان، از مدیرعامل تا کارشناس فروش، به یک منبع واحد و قابل اعتماد از دادهها دسترسی دارند. این موضوع باعث میشود گزارشها و تحلیلها یکپارچه و هماهنگ باشند، تصمیمگیریها بر اساس دادههای واقعی و بهروز انجام شود، هزینههای ناشی از پراکندگی دادهها و تناقضهای اطلاعاتی کاهش یابد و سرعت دسترسی به اطلاعات کلیدی سازمان بهطور چشمگیری افزایش پیدا کند.
بدون انبار داده، سازمانها مجبورند دادهها را از چندین سیستم مختلف استخراج کنند، آنها را دستی ترکیب نمایند و احتمال خطا بسیار بالا میرود. اما انبار داده این فرآیند را خودکار، دقیق و سریع انجام میدهد.
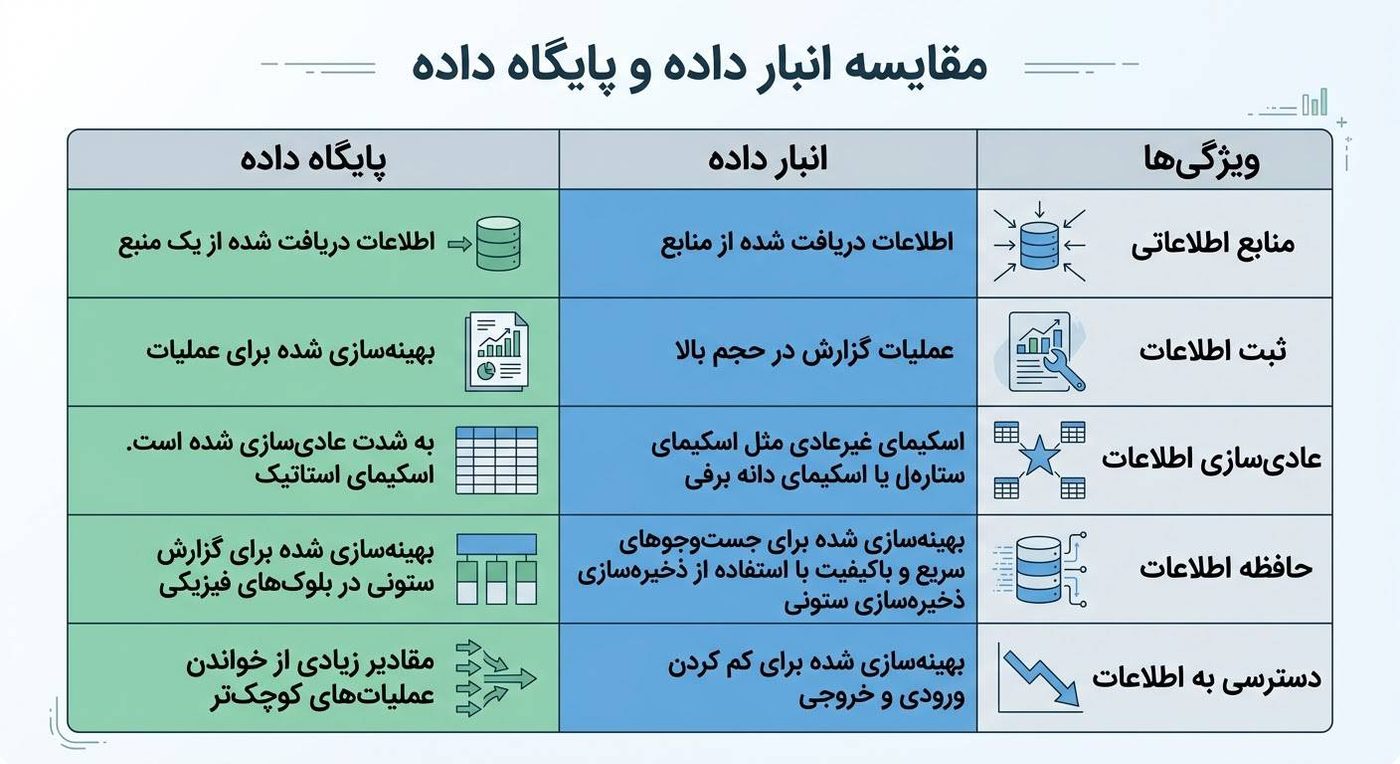
تفاوت انبار داده با پایگاه داده معمولی
بسیاری از افراد تصور میکنند انبار داده همان پایگاه داده است، اما این دو تفاوتهای اساسی دارند. پایگاه داده معمولی برای انجام عملیات روزانه طراحی شده است؛ مثلاً ثبت یک سفارش جدید، بهروزرسانی موجودی انبار یا حذف یک رکورد. این نوع پایگاه دادهها معمولاً با حجم بالایی از عملیات نوشتن و خواندن سریع سر و کار دارند.
اما انبار داده برای تحلیل و گزارشگیری طراحی شده است. در انبار داده، عملیات خواندن بسیار بیشتر از نوشتن است. دادهها معمولاً یکبار وارد انبار داده میشوند و سپس بارها مورد تحلیل قرار میگیرند. به همین دلیل، ساختار انبار داده با پایگاه داده معمولی متفاوت است. در انبار داده از ساختارهایی مانند اسکیمای ستارهای و اسکیمای دانه برفی استفاده میشود که برای تحلیل سریع دادهها بهینه شدهاند.
چرا انبار دا ده اهمیت دارد؟
انبار داده به عنوان «واحد حقیقت» یک سازمان شناخته میشود. یعنی همه افراد سازمان، از مدیرعامل تا کارشناس فروش، به یک منبع واحد و قابل اعتماد از دادهها دسترسی دارند. این موضوع باعث میشود:
- گزارشها و تحلیلها یکپارچه و هماهنگ باشند.
- تصمیمگیریها بر اساس دادههای واقعی و بهروز انجام شود.
- هزینههای ناشی از پراکندگی دادهها و تناقضهای اطلاعاتی کاهش یابد.
- سرعت دسترسی به اطلاعات کلیدی سازمان بهطور چشمگیری افزایش پیدا کند.
بدون انبار داده، سازمانها مجبورند دادهها را از چندین سیستم مختلف استخراج کنند، آنها را دستی ترکیب نمایند و احتمال خطا بسیار بالا میرود. اما انبار داده این فرآیند را خودکار، دقیق و سریع انجام میدهد.
تفاوت OLTP و OLAP
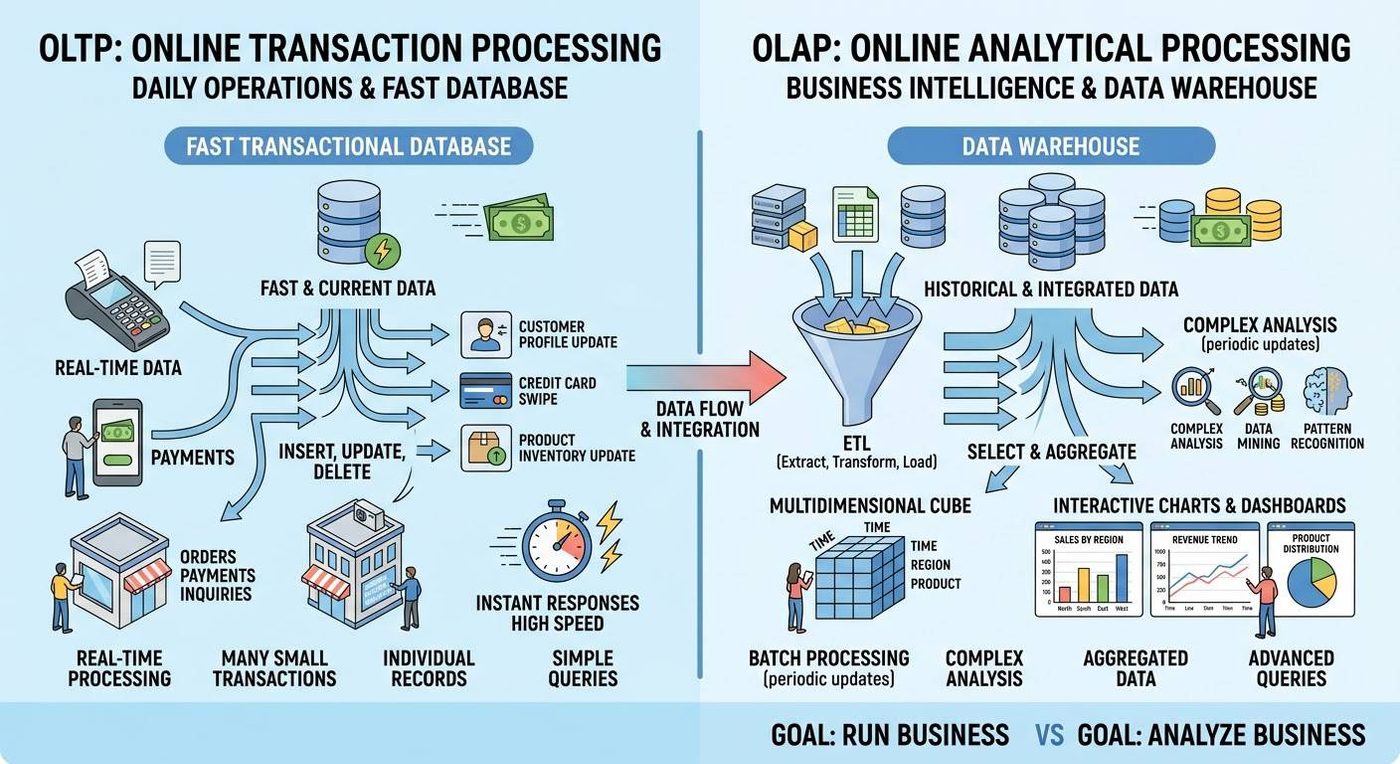
برای درک بهتر انبار داده، باید با دو مفهوم مهم آشنا شوید: OLTP و OLAP.
OLTP چیست؟
OLTP یا «پردازش تراکنشی برخط» (Online Transaction Processing) به سیستمهایی گفته میشود که برای انجام تراکنشهای روزانه طراحی شدهاند. این سیستمها معمولاً با حجم بالایی از عملیات کوچک و سریع سر و کار دارند. مثلاً وقتی یک مشتری در فروشگاه اینترنتی شما یک محصول را خریداری میکند، این تراکنش در یک سیستم OLTP ثبت میشود. پایگاههای داده معمولی که در کسبوکارها استفاده میشوند، معمولاً از نوع OLTP هستند.
ویژگیهای اصلی OLTP عبارتاند از:
- سرعت بالا: تراکنشها باید در کسری از ثانیه انجام شوند.
- حجم بالای عملیات: هزاران یا میلیونها تراکنش در روز.
- ساختار سطری: دادهها به صورت سطر به سطر ذخیره میشوند.
- نوشتن و خواندن مکرر: دادهها مدام بهروزرسانی میشوند.
OLAP چیست؟
OLAP یا «پردازش تحلیلی برخط» (Online Analytical Processing) به سیستمهایی گفته میشود که برای تحلیل دادهها و گزارشگیری طراحی شدهاند. انبار داده معمولاً از نوع OLAP است. در این سیستمها، دادهها یکبار وارد میشوند و سپس بارها مورد تحلیل قرار میگیرند.
ویژگیهای اصلی OLAP عبارتاند از:
- تحلیلهای پیچیده: امکان انجام تحلیلهای چندبعدی.
- حجم بالای خواندن: عملیات خواندن بسیار بیشتر از نوشتن است.
- ساختار ستونی: دادهها به صورت ستون به ستون ذخیره میشوند.
- تاریخمحور: دادههای تاریخی برای تحلیلهای روندی استفاده میشوند.
چرا این تفاوت مهم است؟
درک تفاوت OLTP و OLAP به شما کمک میکند بفهمید چرا انبار داده نمیتواند جایگزین پایگاه داده معمولی شود و بالعکس. هر کدام از این سیستمها برای هدف خاصی طراحی شدهاند و استفاده از آنها در جای مناسب، کارایی سازمان را بهطور چشمگیری افزایش میدهد.
اجزای اصلی یک انبار داده
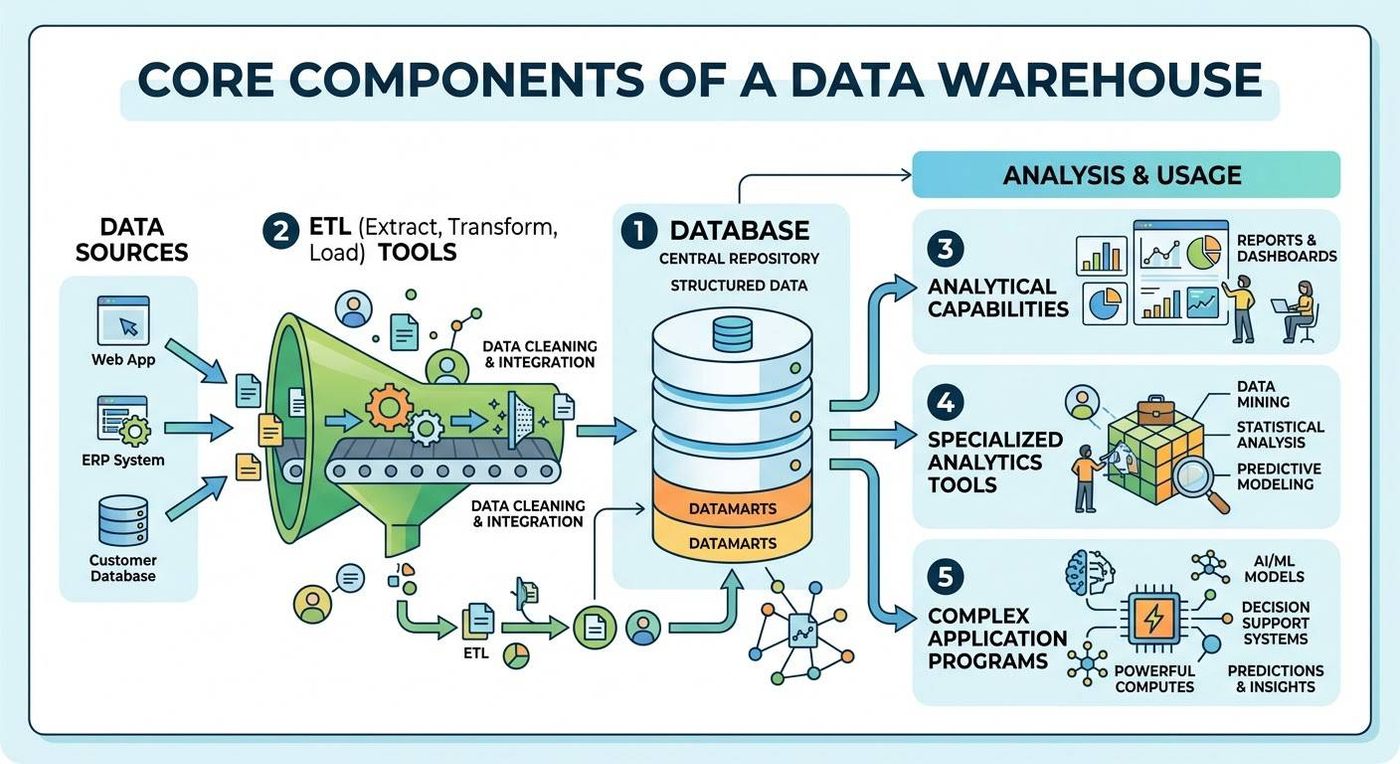
یک انبار داده ساده معمولاً از اجزای زیر تشکیل شده است:
۱. پایگاه داده
برای ذخیره و مدیریت دادهها. این پایگاه داده معمولاً به گونهای طراحی میشود که بتواند حجم عظیمی از دادهها را به سرعت پردازش کند. در انبار داده، پایگاه داده معمولاً از نوع ستونی است، نه سطری. در پایگاه دادههای سطری، دادهها به صورت سطر به سطر ذخیره میشوند و برای عملیات تراکنشی مناسب هستند. اما در پایگاه دادههای ستونی، دادهها به صورت ستون به ستون ذخیره میشوند و برای تحلیلهای پیچیده و گزارشگیری بسیار سریعتر عمل میکنند.
۲. ابزارهای ETL
برای استخراج (Extract)، بارگذاری (Load) و تبدیل (Transform) دادهها به منظور آمادهسازی آنها برای تحلیل. فرآیند ETL یکی از مهمترین بخشهای انبار داده است، زیرا دادهها را از منابع مختلف جمعآوری کرده، آنها را تمیز و یکپارچه میسازد و سپس در انبار داده بارگذاری میکند.
فرآیند ETL شامل سه مرحله اصلی است:
استخراج: دادهها از منابع مختلف مانند پایگاههای داده، فایلهای متنی، APIها و سیستمهای خارجی جمعآوری میشوند.
تبدیل: دادهها تمیز میشوند، فرمتهای مختلف به یک فرمت واحد تبدیل میشوند، مقادیر تکراری حذف میشوند و دادههای ناقص اصلاح میشوند.
بارگذاری: دادههای تمیز و یکپارچه شده در انبار داده بارگذاری میشوند.
۳. قابلیتهای تحلیلی
مانند تحلیلهای آماری، گزارشسازی و دادهکاوی. این قابلیتها به کاربران اجازه میدهند تا الگوها و روندهای موجود در دادهها را شناسایی کنند. ابزارهای تحلیلی معمولاً شامل داشبوردهای بصری، گزارشهای تعاملی و قابلیتهای جستوجو هستند.
۴. ابزارهای تحلیلی خاص
برای بررسی مشتری و ارائه دادههای نهایی. این ابزارها معمولاً به صورت تخصصی برای نیازهای خاص یک سازمان طراحی میشوند. مثلاً یک بانک ممکن است ابزارهایی برای تحلیل ریسک اعتباری مشتریان داشته باشد، در حالی که یک فروشگاه زنجیرهای ممکن است ابزارهایی برای تحلیل رفتار خرید مشتریان طراحی کند.
۵. برنامههای کاربردی و تحلیلی پیچیده
که میتوانند اطلاعات عملیاتی را با استفاده از الگوریتمهای موجود در یک سیستم هوش مصنوعی، خروجیهای مختلفی تولید کنند. این برنامهها معمولاً برای تحلیلهای پیشرفته و پیشبینیهای آینده استفاده میشوند. مثلاً میتوانند پیشبینی کنند که کدام مشتریان احتمالاً در ماه آینده خرید خواهند کرد یا کدام محصولات ممکن است با کمبود موجودی مواجه شوند.
به کارگیری این سیستم اهمیت زیادی دارد، زیرا بدون آن، دادهها پراکنده باقی میمانند و ارزش واقعی خود را نشان نمیدهند. انبار داده با یکپارچهسازی دادهها، به سازمانها کمک میکند تا از اطلاعات خود بهترین استفاده را ببرند.
فرآیند ETL به طور کامل
فرآیند ETL (استخراج، تبدیل، بارگذاری) قلب تپنده انبار داده است. بدون ETL، دادهها نمیتوانند به انبار داده وارد شوند و تحلیلها امکانپذیر نخواهند بود. بیایید این فرآیند را به طور کامل بررسی کنیم.
مرحله اول: استخراج (Extract)
در این مرحله، دادهها از منابع مختلف جمعآوری میشوند. این منابع میتوانند شامل موارد زیر باشند:
- پایگاههای داده عملیاتی: مانند سیستمهای فروش، حسابداری و مدیریت مشتریان. این پایگاهها معمولاً از نوع OLTP هستند و دادههای تراکنشی روزانه را ذخیره میکنند.
- فایلهای متنی: مانند فایلهای CSV، Excel و XML. این فایلها معمولاً حاوی دادههایی هستند که به صورت دستی یا توسط سیستمهای خارجی تولید شدهاند.
- APIها: رابطهای برنامهنویسی که به سیستمها اجازه میدهند با یکدیگر ارتباط برقرار کنند. مثلاً API یک سیستم پرداخت آنلاین میتواند دادههای تراکنشها را در اختیار انبار داده قرار دهد.
- سیستمهای خارجی: مانند دادههای بازار، دادههای آبوهوا و دادههای جمعیتی. این دادهها میتوانند برای تحلیلهای تکمیلی مفید باشند.
- لاگهای سیستم: مانند لاگهای سرور، لاگهای اپلیکیشن و لاگهای امنیتی. این لاگها میتوانند برای شناسایی الگوهای رفتاری یا مشکلات فنی استفاده شوند.
استخراج دادهها میتواند به صورت دستهای (Batch) یا جریانی (Streaming) انجام شود. در استخراج دستهای، دادهها در بازههای زمانی مشخص (مثلاً هر شب) جمعآوری میشوند. در استخراج جریانی، دادهها به صورت لحظهای و مداوم جمعآوری میشوند. انتخاب بین این دو روش بستگی به نیاز سازمان دارد. مثلاً اگر سازمان نیاز به تحلیلهای لحظهای داشته باشد، استخراج جریانی مناسبتر است.
مرحله دوم: تبدیل (Transform)
در این مرحله، دادههای خام تمیز و آمادهسازی میشوند. این فرآیند شامل موارد زیر است:
- تمیزکاری دادهها: حذف دادههای تکراری، اصلاح دادههای ناقص و رفع خطاها. مثلاً اگر یک رکورد تاریخ به صورت «۱۴۰۳/۱۳/۴۵» ثبت شده باشد، این خطا اصلاح میشود.
- یکپارچهسازی دادهها: تبدیل فرمتهای مختلف به یک فرمت واحد. مثلاً تاریخها، واحدهای پول و کدهای محصول باید یکپارچه شوند.
- غنیسازی دادهها: اضافه کردن اطلاعات جدید به دادههای موجود. مثلاً اضافه کردن اطلاعات جغرافیایی به دادههای فروش.
- تجمیع دادهها: خلاصهسازی دادهها برای تحلیلهای سریعتر. مثلاً جمع فروش روزانه به فروش ماهانه.
- اعتبارسنجی دادهها: اطمینان از صحت و دقت دادهها. مثلاً بررسی اینکه آیا مبلغ فروش با تعداد محصولات فروختهشده همخوانی دارد یا خیر.
فرآیند تبدیل معمولاً پیچیدهترین بخش ETL است، زیرا نیازمند درک عمیق از دادهها و قوانین کسبوکار است. یک اشتباه در این مرحله میتواند منجر به تحلیلهای نادرست شود.
مرحله سوم: بارگذاری (Load)
در این مرحله، دادههای تمیز و آمادهشده در انبار داده بارگذاری میشوند. این بارگذاری میتواند به صورت کامل (Full Load) یا افزایشی (Incremental Load) انجام شود. در بارگذاری کامل، تمام دادهها از نو بارگذاری میشوند. در بارگذاری افزایشی، فقط دادههای جدید یا تغییر یافته بارگذاری میشوند.
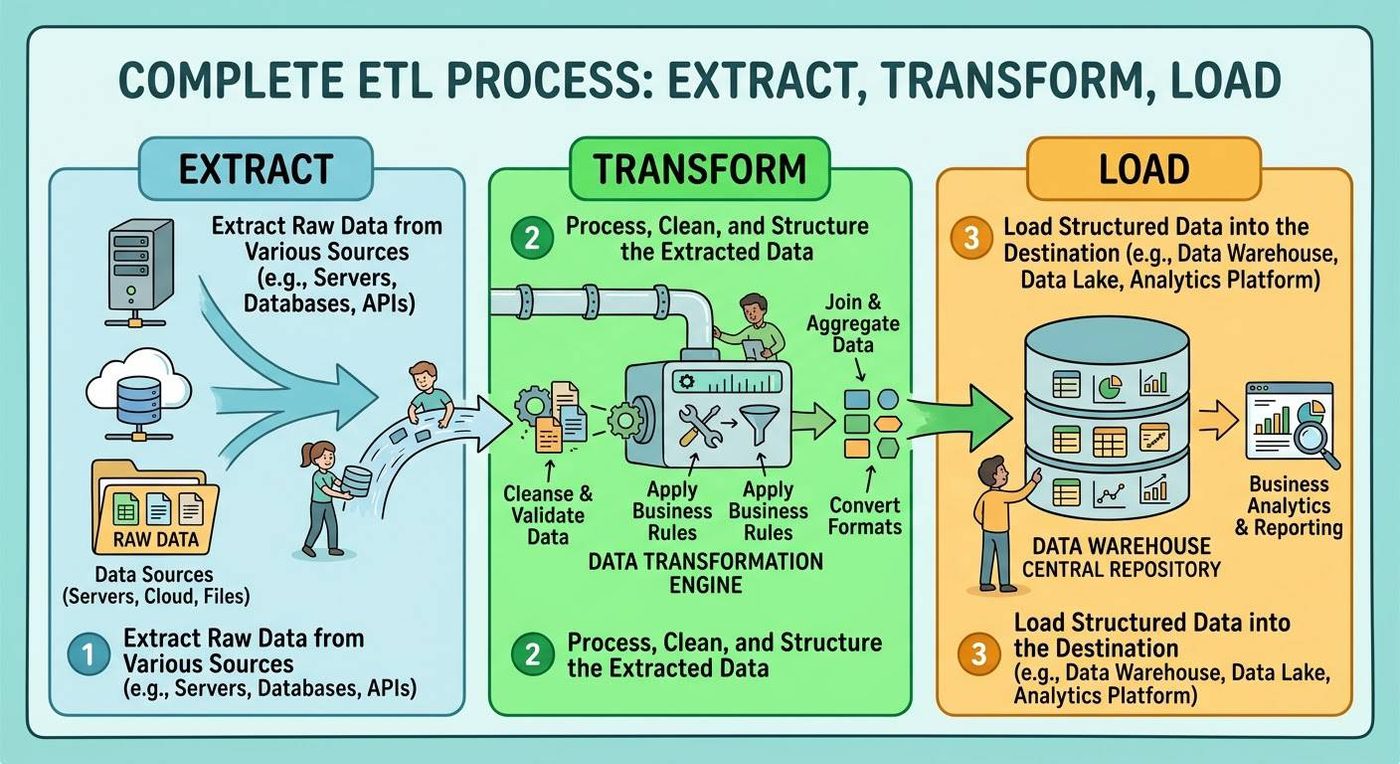
بارگذاری افزایشی معمولاً سریعتر و کمهزینهتر است، اما نیازمند مدیریت دقیقتر است تا اطمینان حاصل شود که دادههای جدید با دادههای موجود تداخل ندارند.
چالشهای فرآیند ETL
فرآیند ETL با چالشهایی همراه است:
- حجم بالای دادهها: وقتی حجم دادهها زیاد است، فرآیند ETL میتواند زمانبر باشد.
- تنوع منابع: دادهها از منابع مختلف با فرمتهای متفاوت میآیند و یکپارچهسازی آنها چالشبرانگیز است.
- کیفیت دادهها: دادههای خام ممکن است ناقص، تکراری یا نادرست باشند.
- همگامسازی: اطمینان از اینکه دادهها بهروز هستند و با سیستمهای عملیاتی همگام میشوند.
- امنیت: حفاظت از دادههای حساس در طول فرآیند ETL.
انواع اسکیما در انبار داده
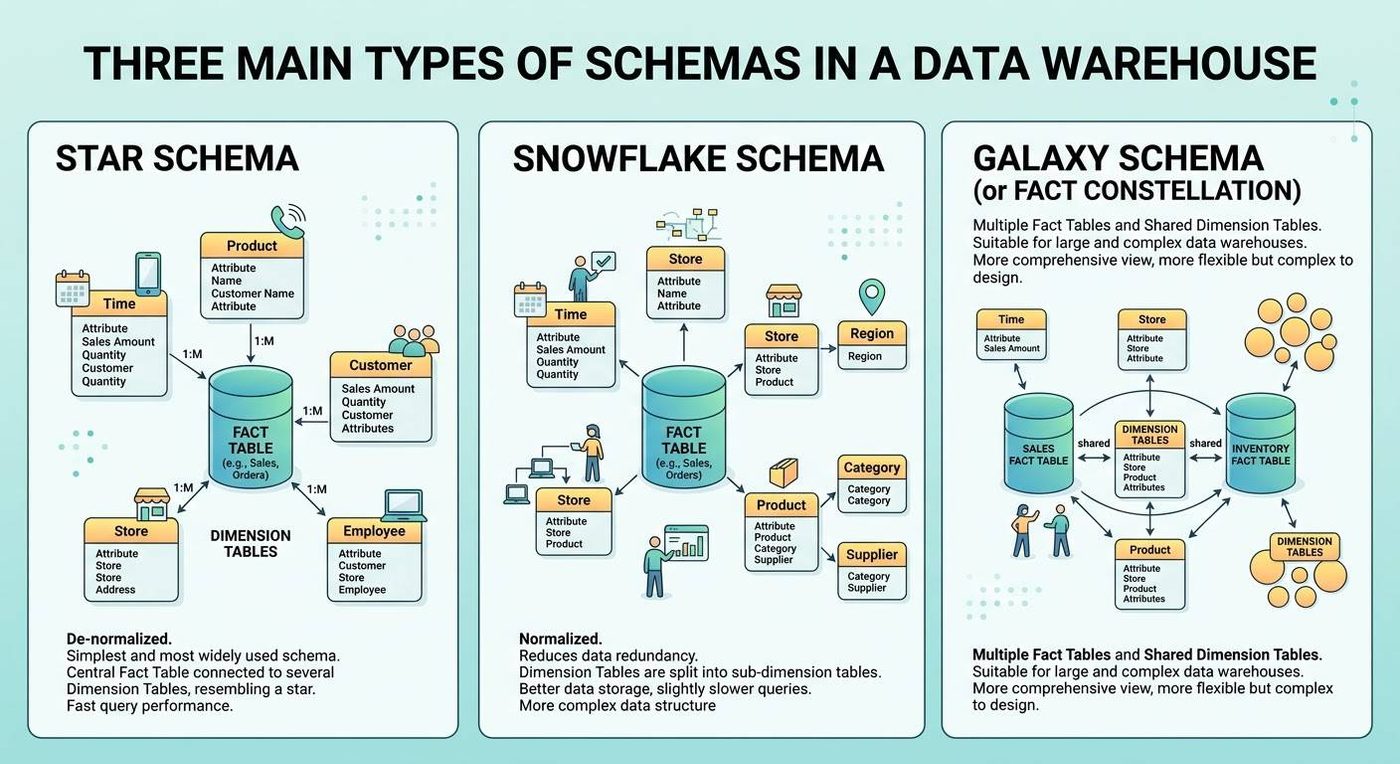
اسکیما به ساختار منطقی انبار داده گفته میشود که نحوه سازماندهی جداول و ارتباط بین آنها را مشخص میکند. سه نوع اصلی اسکیما در انبار داده وجود دارد:
۱. اسکیمای ستارهای (Star Schema)
در این اسکیما، یک جدول مرکزی به نام «جدول حقیقت» (Fact Table) وجود دارد که با چندین جدول ابعادی (Dimension Tables) ارتباط دارد. ساختار این اسکیما مانند یک ستاره است، به همین دلیل اسکیمای ستارهای نامیده میشود.
مزایا:
- سادگی و درک آسان.
- سرعت بالای پرسوجوها.
- مناسب برای تحلیلهای ساده.
معایب:
- ممکن است دادهها تکراری شوند.
- برای تحلیلهای پیچیده مناسب نیست.
۲. اسکیمای دانه برفی (Snowflake Schema)
این اسکیما مشابه اسکیمای ستارهای است، اما جداول ابعادی به صورت نرمالسازی شده و به چندین جدول کوچکتر تقسیم میشوند. ساختار این اسکیما مانند یک دانه برف است.
مزایا:
- کاهش تکرار دادهها.
- صرفهجویی در فضای ذخیرهسازی.
- مناسب برای تحلیلهای پیچیده.
معایب:
- پیچیدگی بیشتر.
- سرعت پایینتر پرسوجوها به دلیل نیاز به joinهای بیشتر.
۳. اسکیمای کهکشانی (Galaxy Schema)
این اسکیما ترکیبی از چندین اسکیمای ستارهای است که از چندین جدول حقیقت استفاده میکنند. این اسکیما برای سازمانهای بزرگ با چندین حوزه کسبوکار مناسب است.
مزایا:
- انعطافپذیری بالا.
- مناسب برای تحلیلهای چندحوزهای.
معایب:
- پیچیدگی بالا.
- نیازمند طراحی دقیق.
انواع داده در انبار داده
دادههایی که در انبار داده ذخیره میشوند، میتوانند به سه دسته اصلی تقسیم شوند:
۱. دادههای ساختاریافته (Structured Data)
این دادهها دارای ساختار مشخص و منظمی هستند و معمولاً در قالب جداول ذخیره میشوند. مثالهایی از این دادهها عبارتاند از:
- دادههای مالی و حسابداری.
- دادههای مشتریان.
- دادههای فروش.
- دادههای موجودی انبار.
۲. دادههای نیمهساختاریافته (Semi-Structured Data)
این دادهها دارای ساختار مشخصی نیستند، اما دارای برچسبها یا نشانههایی هستند که میتوانند برای سازماندهی آنها استفاده شوند. مثالهایی از این دادهها عبارتاند از:
- فایلهای XML.
- فایلهای JSON.
- ایمیلها.
- صفحات وب.
۳. دادههای بدون ساختار (Unstructured Data)
این دادهها هیچ ساختار مشخصی ندارند و معمولاً به صورت متن، تصویر، صدا یا ویدیو ذخیره میشوند. مثالهایی از این دادهها عبارتاند از:
- متنهای آزاد.
- تصاویر.
- فایلهای صوتی.
- فایلهای ویدیویی.
- پستهای شبکههای اجتماعی.
انبار داده معمولاً برای ذخیره و تحلیل دادههای ساختاریافته و نیمهساختاریافته طراحی شده است. اما با پیشرفت فناوری، انبار دادههای مدرن میتوانند دادههای بدون ساختار را نیز پردازش کنند.
ابزارهای انبار داده
امروزه ابزارهای متعددی برای طراحی، پیادهسازی و مدیریت انبار داده وجود دارد. در ادامه برخی از محبوبترین آنها را معرفی میکنیم:
۱. Snowflake
Snowflake یک انبار داده ابری است که به دلیل سادگی، مقیاسپذیری و عملکرد بالا محبوبیت زیادی پیدا کرده است. این ابزار به سازمانها اجازه میدهد تا بدون نیاز به مدیریت زیرساخت، انبار داده خود را راهاندازی کنند.
۲. Amazon Redshift
Amazon Redshift یک انبار داده ابری از آمازون است که برای تحلیلهای سریع و حجم بالای دادهها طراحی شده است. این ابزار با سایر سرویسهای آمازون یکپارچه میشود و برای کسبوکارهای مختلف مناسب است.
۳. Google BigQuery
Google BigQuery یک انبار داده ابری از گوگل است که برای تحلیلهای بزرگمقیاس طراحی شده است. این ابزار از زبان SQL پشتیبانی میکند و میتواند حجم عظیمی از دادهها را به سرعت پردازش کند.
۴. Microsoft Azure Synapse
Microsoft Azure Synapse یک انبار داده ابری از مایکروسافت است که امکانات تحلیل داده و یکپارچهسازی را در یک پلتفرم ارائه میدهد. این ابزار برای سازمانهایی که از سرویسهای مایکروسافت استفاده میکنند، مناسب است.
۵. Oracle Exadata
Oracle Exadata یک انبار داده سختافزاری و نرمافزاری از اوراکل است که برای عملکرد بالا و قابلیت اطمینان طراحی شده است. این ابزار برای سازمانهای بزرگ با حجم بالای داده مناسب است.
۶. Teradata
Teradata یکی از پیشگامان انبار داده است که برای تحلیلهای پیچیده و حجم بالای داده طراحی شده است. این ابزار در سازمانهای بزرگ و صنایع مختلف استفاده میشود.
مزایای استفاده از انبار داده
بیشک به کارگیری انبار داده میتواند مزایای زیادی به همراه داشته باشد. این سیستم به سازمانها اجازه میدهد تا مقادیر زیادی از دادههای مختلف را تجزیه و تحلیل نمایند و از اطلاعات تجزیهشده، نتایج قابلتوجهی به دست آورند.
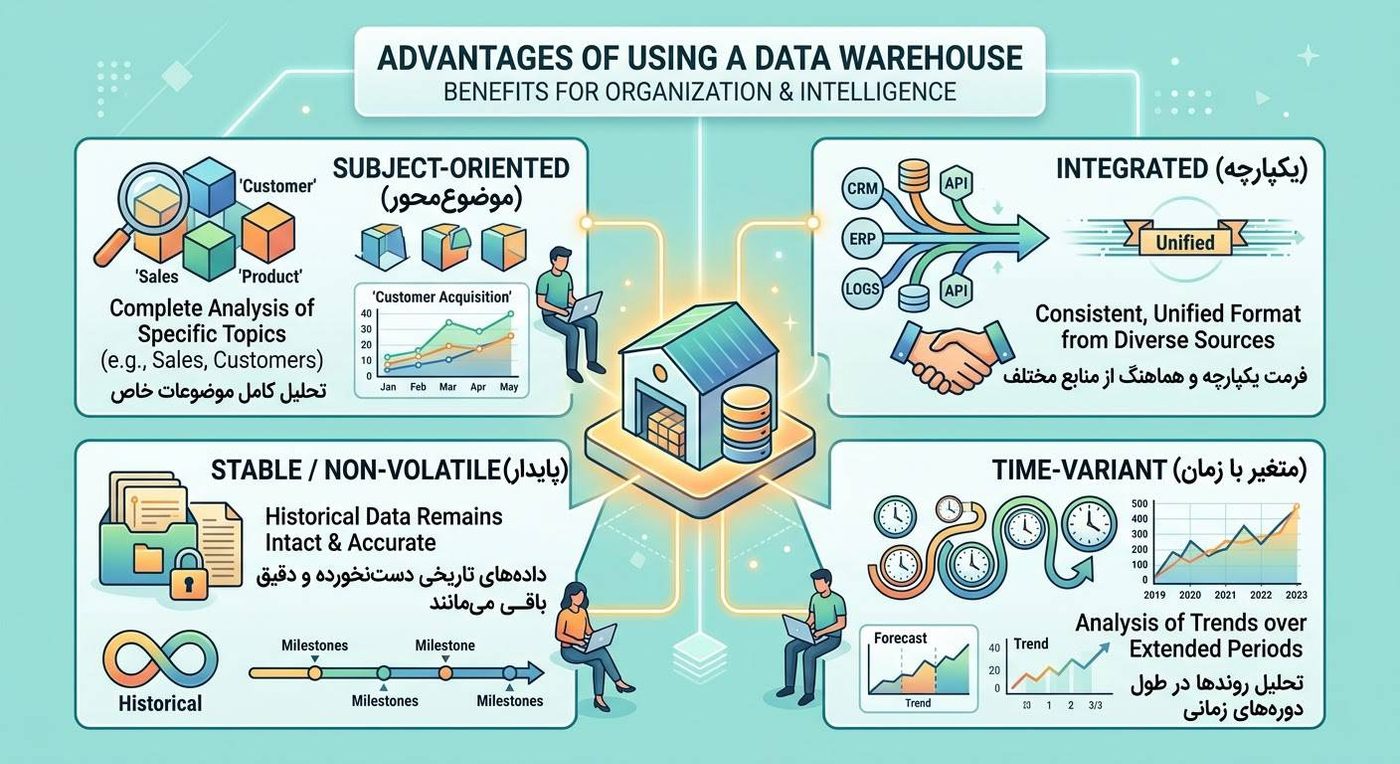
انبار داده چهار ویژگی منحصربهفرد دارد که باعث افزایش مزایای آن میشود:
۱. موضوعمحور بودن
انبار داده میتواند اطلاعات موجود در مورد یک موضوع خاص را به صورت کامل تحلیل نماید. مثلاً تمام دادههای مربوط به «مشتریان» یا «فروش» را یکجا بررسی میکند. این ویژگی باعث میشود که تحلیلها دقیقتر و متمرکزتر باشند. در واقع، انبار داده به جای اینکه همه دادهها را در یک مجموعه بزرگ و بینظم ذخیره کند، آنها را بر اساس موضوع دستهبندی میکند تا تحلیلگران بتوانند به راحتی به دادههای مورد نیاز خود دسترسی پیدا کنند.
۲. یکپارچه بودن
انبار داده اطلاعات مختلف را یکپارچه میسازد و سازگاری سیستم را افزایش میدهد. یعنی دادههایی که از منابع مختلف با فرمتهای متفاوت آمدهاند، در انبار داده به یک فرمت واحد تبدیل میشوند. مثلاً ممکن است تاریخها در یک سیستم به صورت «۱۴۰۳/۰۵/۱۲» و در سیستم دیگر به صورت «۱۲/۰۵/۱۴۰۳» ذخیره شده باشند. انبار داده این تاریخها را به یک فرمت واحد تبدیل میکند تا تحلیلها دچار خطا نشوند.
۳. پایدار بودن
اطلاعات موجود در انبار داده همیشه پایدار بوده و هیچگاه تغییر نمیکنند. یعنی دادههای تاریخی دستنخورده باقی میمانند و میتوان به آنها به عنوان یک مرجع قابل اعتماد نگاه کرد. این ویژگی باعث میشود که انبار داده به عنوان یک آرشیو تاریخی از دادههای سازمان عمل کند. حتی اگر دادهها در سیستمهای عملیاتی تغییر کنند یا حذف شوند، نسخه اصلی آنها در انبار داده باقی میماند.
۴. متغیر بودن با زمان
انبار داده برای تجزیه و تحلیل، به تاریخ اطلاعات نیز نگاه میکند و دستهبندی بر اساس تاریخ انجام میشود. این ویژگی به سازمانها اجازه میدهد تا روندهای زمانی را شناسایی کنند و پیشبینیهای آینده را بر اساس دادههای گذشته انجام دهند. مثلاً میتوانند بفهمند که فروش یک محصول خاص در طول سال چگونه تغییر کرده است و چه الگویی دارد.
مزایای عملیاتی انبار داده
اگر یک انبار داده به خوبی طراحی شود، میتواند مزایای عملیاتی زیر را به همراه داشته باشد:
سرعت بالاتر: انبار داده میتواند درخواستهای پایگاه داده را بسیار سریعتر ثبت کند، زیرا برای تحلیل بهینه شده است.
توان عملیاتی بالاتر: انبار داده میتواند حجم عظیمی از دادهها را پردازش کند بدون اینکه سرعت سیستم کاهش یابد.
انعطافپذیری بیشتر: انبار داده به سازمانها اجازه میدهد تا تحلیلهای مختلفی را بدون نیاز به تغییر ساختار پایگاه داده انجام دهند.
کاهش حجم دادهها: انبار داده میتواند حجم دادهها را برای بررسی و آنالیز موضوعات مختلف کاهش دهد، زیرا دادهها را خلاصهسازی و یکپارچه میکند.
پشتیبانی از هوش تجاری: انبار داده میتواند به عنوان یک پایه ضروری هوش تجاری شناسایی شود که گزارشها و چارتهای مختلفی را در اختیار کاربران نهایی خود قرار میدهد.
معماری انبار داده
به صورت کلی معماری یک انبار داده بر اساس نیازهای سازمان مشخص میشود. از جمله رایجترین معماریهای به کار رفته در این زمینه عبارتاند از:
۱. معماری ساده
در این معماری، همه انبار دادهها ساختار مشترکی داشته و اطلاعات در انبار مرکزی ذخیره میشود. زیرشاخهها هم توسط منابع اطلاعاتی تغذیه شده و خروجی را در اختیار کاربر قرار میدهند. این معماری برای سازمانهای کوچکتر مناسب است، زیرا پیچیدگی کمتری دارد و راهاندازی آن سریعتر است.
۲. معماری ساده با یک منطقه صحنهای
دادههای عملیاتی باید پردازش شوند و سپس در انبار داده قرار گیرند. با اینکه این پروسه با برنامهسازی پیاده میشود، ولی خیلی از تیمها آن را نادیده میگیرند. منطقه صحنهای (Staging Area) مکانی است که دادهها قبل از ورود به انبار داده در آنجا آمادهسازی میشوند. این منطقه به عنوان یک بافر بین سیستمهای عملیاتی و انبار داده عمل میکند و از بار اضافی روی انبار داده جلوگیری میکند.
۳. معماری هاب و اسپوک
این سیستم به سازمان اجازه میدهد تا از اطلاعات و انبار داده خود برای خدمترسانی به کسبوکارهای مختلف استفاده کند. در این معماری، یک انبار مرکزی (هاب) وجود دارد که دادهها را از منابع مختلف دریافت کرده و به بخشهای مختلف (اسپوکها) ارسال میکند. هر اسپوک میتواند یک دیتا مارت باشد که نیازهای یک بخش خاص از سازمان را برآورده میکند.
۴. معماری سندباکس
سندباکس یا جعبههای شنی در واقع مناطق ایمنی هستند که به شرکتها اجازه بررسی اطلاعات با روشهای جدید را میدهند. آنها بدون پروتکل و روشهای رسمی فعالیت خود را به اتمام میرسانند. این محیطها برای آزمایش و نوآوری بسیار مفید هستند. مثلاً یک تیم میتواند در سندباکس یک مدل یادگیری ماشین جدید را روی دادههای انبار داده آزمایش کند بدون اینکه روی سیستم اصلی تأثیری بگذارد.
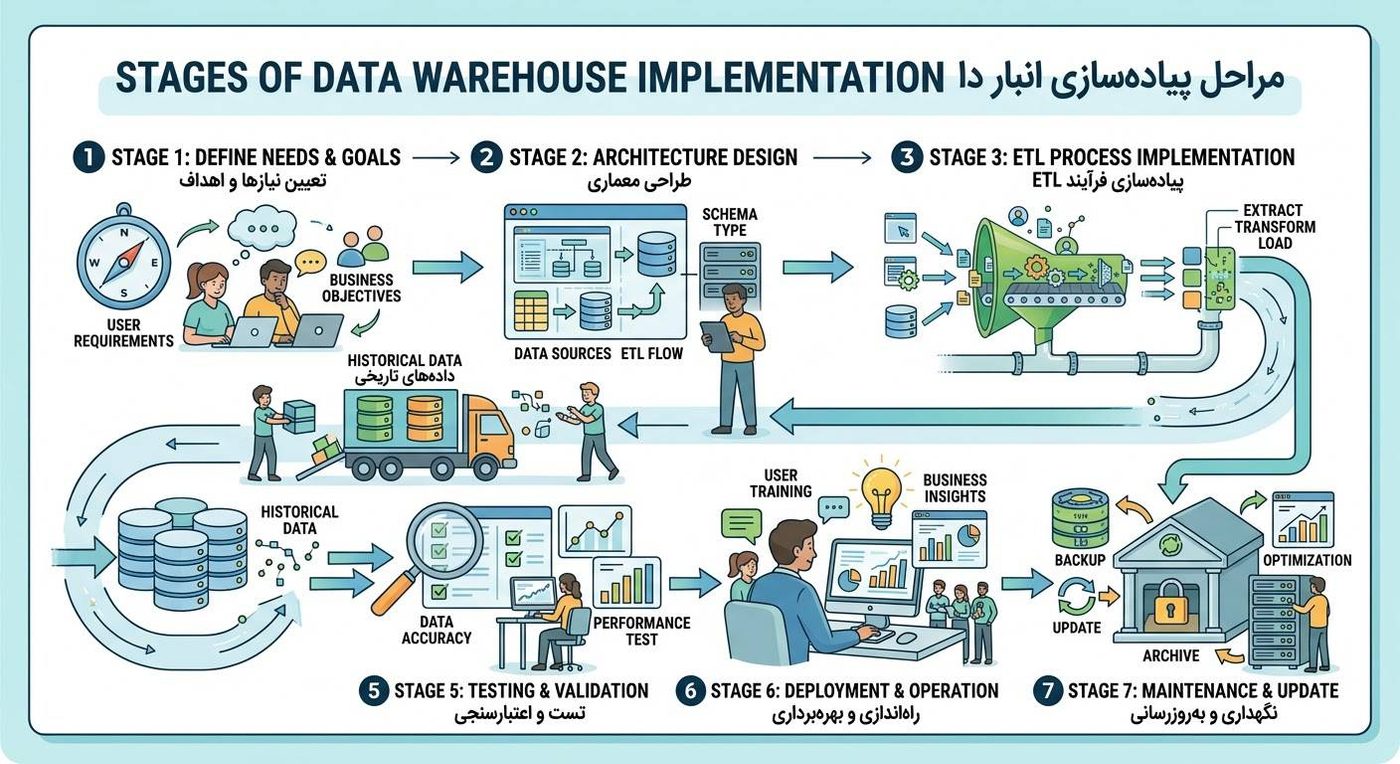
مراحل پیادهسازی انبار داده
پیادهسازی موفق این راهکار نیازمند برنامهریزی دقیق و اجرای مرحلهبهمرحله است. در ادامه مراحل اصلی پیادهسازی را به طور کامل بررسی میکنیم:
مرحله ۱: تعیین نیازها و اهداف
اولین قدم در پیادهسازی این سیستم، تعیین نیازها و اهداف سازمان است. باید مشخص شود که این زیرساخت برای چه هدفی استفاده میشود، چه کسانی از آن استفاده میکنند و چه نوع تحلیلهایی مورد نیاز است.
در این مرحله، باید با ذینفعان مختلف سازمان صحبت کنید و نیازهای آنها را جمعآوری کنید. مثلاً ممکن است تیم فروش نیاز به تحلیل روند فروش داشته باشد، در حالی که تیم مالی نیاز به تحلیل هزینهها دارد. همچنین باید اهداف کسبوکار را مشخص کنید. مثلاً آیا هدف انبار داده افزایش فروش است یا کاهش هزینهها؟
خروجی این مرحله معمولاً یک سند نیازمندیها است که شامل اهداف، نیازها و محدودیتهای انبار داده میشود.
مرحله ۲: طراحی معماری
پس از تعیین نیازها، باید معماری انبار داده طراحی شود. این شامل انتخاب نوع اسکیما، تعیین منابع داده، طراحی جداول و تعیین فرآیندهای ETL است.
در این مرحله باید تصمیم بگیرید که از کدام معماری (ساده، هاب و اسپوک، سندباکس) استفاده میکنید. همچنین باید مشخص کنید که دادهها از چه منابعی جمعآوری میشوند و چگونه به انبار داده منتقل میشوند. طراحی جداول نیز باید بر اساس نیازهای تحلیلی انجام شود. مثلاً اگر نیاز به تحلیل فروش بر اساس محصول، مشتری و زمان دارید، باید جداول ابعادی مناسب طراحی شوند.
خروجی این مرحله یک سند طراحی است که شامل نمودار معماری، طراحی جداول و فرآیندهای ETL میشود.
مرحله ۳: پیادهسازی فرآیند ETL
در این مرحله، فرآیندهای ETL طراحی و پیادهسازی میشوند. این شامل استخراج دادهها از منابع مختلف، تبدیل آنها به فرمت مناسب و بارگذاری آنها در انبار داده است.
برای پیادهسازی ETL، میتوانید از ابزارهای ETL مانند Informatica، Talend، Microsoft SSIS یا Apache NiFi استفاده کنید. این ابزارها به شما اجازه میدهند که فرآیندهای ETL را به صورت بصری طراحی و اجرا کنید.
در این مرحله باید اطمینان حاصل کنید که دادهها به درستی استخراج، تبدیل و بارگذاری میشوند. همچنین باید مکانیزمهای خطاگیری و بازگشت (Rollback) را پیادهسازی کنید تا در صورت بروز خطا، فرآیند ETL متوقف شود و دادههای ناقص وارد انبار داده نشوند.
مرحله ۴: بارگذاری دادههای اولیه
پس از پیادهسازی ETL، دادههای اولیه در انبار داده بارگذاری میشوند. این دادهها معمولاً شامل دادههای تاریخی موجود در سازمان هستند.
بارگذاری دادههای اولیه میتواند زمانبر باشد، به ویژه اگر حجم دادهها زیاد باشد. در این مرحله باید اطمینان حاصل کنید که تمام دادههای تاریخی به درستی بارگذاری شدهاند و هیچ دادهای از قلم نیفتاده است.
مرحله ۵: تست و اعتبارسنجی
در این مرحله، انبار داده تست و اعتبارسنجی میشود تا اطمینان حاصل شود که دادهها به درستی بارگذاری شدهاند و تحلیلها به درستی انجام میشوند.
تستها معمولاً شامل موارد زیر هستند:
- تست صحت دادهها: بررسی اینکه آیا دادههای بارگذاری شده با دادههای منابع اصلی همخوانی دارند یا خیر.
- تست عملکرد: بررسی سرعت پرسوجوها و تحلیلها.
- تست امنیت: بررسی اینکه آیا مکانیزمهای امنیتی به درستی کار میکنند یا خیر.
- تست کاربرپسندی: بررسی اینکه آیا کاربران میتوانند به راحتی از انبار داده استفاده کنند یا خیر.
در صورت بروز مشکل، باید فرآیندهای ETL یا طراحی انبار داده اصلاح شوند.
مرحله ۶: راهاندازی و بهرهبرداری
پس از تست موفق، انبار داده راهاندازی میشود و کاربران میتوانند از آن استفاده کنند. در این مرحله، آموزش کاربران و ارائه مستندات لازم نیز انجام میشود.
آموزش کاربران بسیار مهم است، زیرا اگر کاربران ندانند چگونه از انبار داده استفاده کنند، ارزش آن به طور کامل محقق نمیشود. آموزش میتواند شامل کارگاههای عملی، ویدیوهای آموزشی و مستندات آنلاین باشد.
مرحله ۷: نگهداری و بهروزرسانی
انبار داده نیازمند نگهداری و بهروزرسانی مستمر است. این شامل بهروزرسانی دادهها، بهبود عملکرد و رفع مشکلات است.
نگهداری انبار داده شامل موارد زیر است:
- بهروزرسانی دادهها: دادههای جدید باید به طور منظم به انبار داده اضافه شوند.
- بهینهسازی عملکرد: پرسوجوها و تحلیلها باید به طور منظم بهینه شوند تا سرعت انبار داده حفظ شود.
- رفع مشکلات: مشکلات فنی باید به سرعت شناسایی و رفع شوند.
- پشتیبانگیری: دادههای انبار داده باید به طور منظم پشتیبانگیری شوند تا در صورت بروز مشکل، قابل بازیابی باشند.
تکامل انبار داده: از آنالیز داده تا هوش مصنوعی و یادگیری ماشین
این سیستم برای اولین بار در اواخر دهه ۸۰ میلادی وارد دنیا شد. هدف اولیه آن کمک به جریان دادهها از سیستمهای عملیاتی به سیستمهای پشتیبانی تصمیم (DSS) بود. نسخههای اولیه این راهکار به عملیاتهای خاصی نیاز داشتند. اکثر سازمانها چندین محیط DSS را مورد استفاده قرار میدادند. این مسئله به کاربران خدمات زیادی ارائه میکرد، اما محیطهای DSS معمولاً از دادههای مشابه استفاده میکردند و همین مسئله جمعآوری، تمیز کردن و ادغام دادهها را کمی سختتر میکرد.
هرچه این زیرساختها تکامل پیدا کردند، ساختارهای جدیدی برای این سرویس ایجاد شد. این سیستمها کارآمدتر شدند و از فروشگاههای اطلاعاتی به یک زیرساخت مهم برای کسبوکارهای مختلف تبدیل شدند. تا کنون این فناوری پیشرفتها و تکاملهای زیادی را به چشم دیده است.
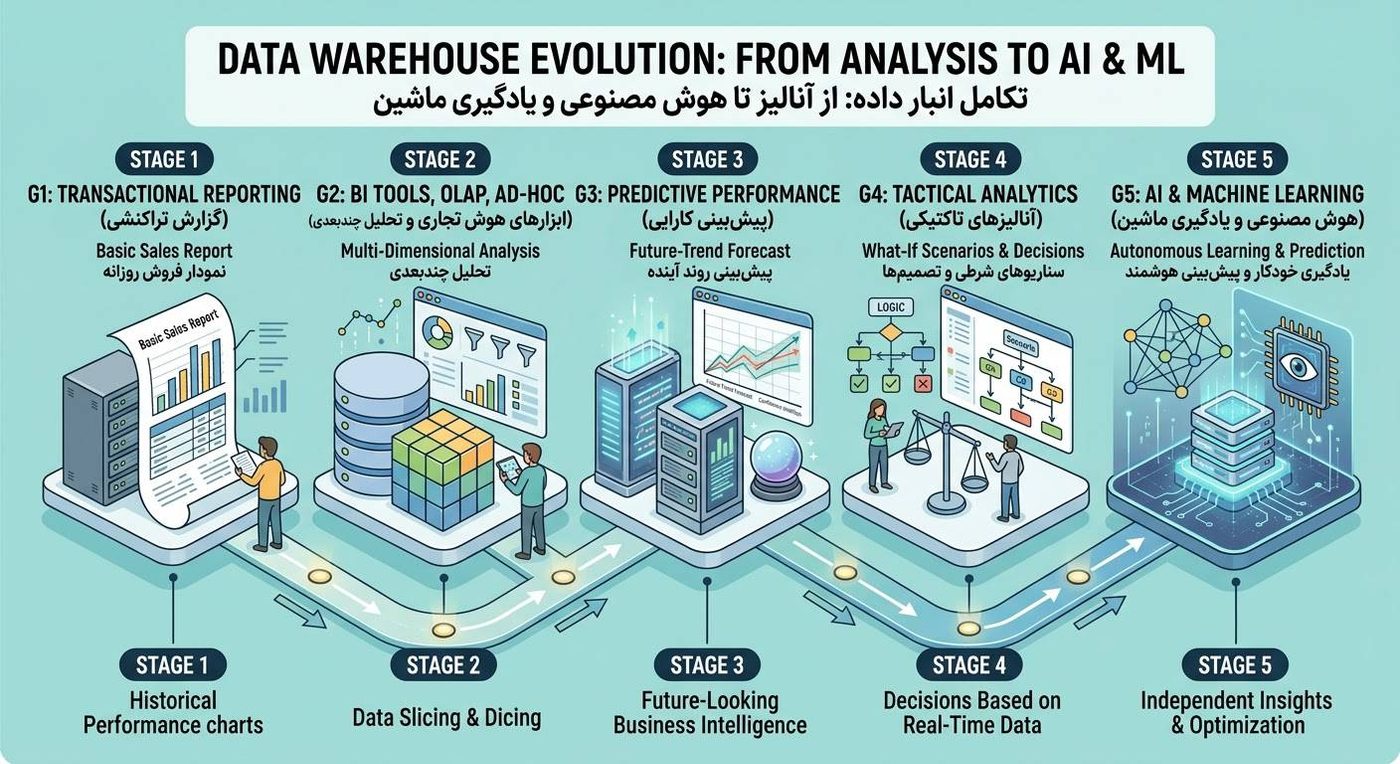
مراحل تکامل انبار داده را میتوان به صورت زیر دستهبندی کرد:
مرحله ۱: گزارش تراکنشی
اطلاعات نسبی برای ایجاد نمودار از عملکرد کسبوکار ایجاد میکند. این مرحله ابتداییترین سطح استفاده از این سیستم است. در این مرحله، سازمانها فقط میتوانند گزارشهای ساده از تراکنشهای خود تهیه کنند. مثلاً گزارش فروش روزانه یا گزارش موجودی انبار.
مرحله ۲: برش و تاس، ادهاک و ابزارهای هوش تجاری
توانایی سیستم برای انجام آنالیزهای قویتر را افزایش میدهد. در این مرحله، کاربران میتوانند تحلیلهای پیچیدهتری انجام دهند. مثلاً میتوانند دادهها را بر اساس ابعاد مختلف (مانند زمان، مکان، محصول) برش دهند و تحلیل کنند. ابزارهای هوش تجاری مانند Tableau، Power BI و Qlik به کاربران اجازه میدهند که داشبوردهای تعاملی بسازند و دادهها را بصریسازی کنند.
مرحله ۳: پیشبینی کارایی آینده
ایجاد هوش تجاری بصری و آیندهنگر. در این مرحله، این زیرساخت میتواند به پیشبینی روندهای آینده کمک کند. مثلاً میتواند پیشبینی کند که فروش یک محصول خاص در ماه آینده چگونه خواهد بود. این پیشبینیها معمولاً با استفاده از مدلهای آماری و یادگیری ماشین انجام میشوند.
مرحله ۴: آنالیزهای تاکتیکی
سناریوهای شرطی ایجاد کرده و تصمیمهای شرکت را بر اساس اطلاعات ورودی تغییر میدهد. این مرحله به سازمانها اجازه میدهد تا سناریوهای مختلف را بررسی کنند و ببینند اگر یک متغیر تغییر کند، چه اتفاقی میافتد. مثلاً میتوانند بررسی کنند که اگر قیمت یک محصول ۱۰ درصد افزایش یابد، چه تأثیری بر فروش خواهد داشت.
مرحله ۵: ذخیرهسازی چند ماه و چند سال اطلاعات
اطلاعات را برای چند هفته یا چند ماه ذخیره میکند. این مرحله به سازمانها اجازه میدهد تا به دادههای تاریخی دسترسی داشته باشند و روندهای بلندمدت را تحلیل کنند. مثلاً میتوانند روند فروش یک محصول را در طول چند سال بررسی کنند و الگوهای فصلی را شناسایی کنند.
پشتیبانی از هر کدام از این مراحل میتواند انواع داده را تغییر دهد. به خصوص سه مرحله آخر میتوانند رنجهای جدیدی از تواناییهای تحلیلی و اطلاعاتی ایجاد نمایند. امروزه یادگیری ماشین و هوش مصنوعی تقریباً هر صنعتی را متحول کردهاند. این فناوری نیز از این قاعده مستثنی نیست.
گسترش دادههای بزرگ و به کارگیری تجهیزات جدید، الزام استفاده از نسخههای جدید را دو برابر کرده است. به صورت کلی نسخههای مستقل را میتوان به عنوان جدیدترین نسل این سیستم شناسایی کرد. این مدل به شرکتها اجازه میدهد تا اطلاعات بیشتری را استخراج نمایند و هزینههای نهایی را کاهش دهند. این مسئله کیفیت نهایی کار را افزایش میدهد.
انبار داده ابری چیست؟
یکی از زیرمجموعههای سیستمهای انبار داده، انبار داده ابری است. انبار داده ابری به حساب میآید که سرویسهای داخلی آن به صورت Cloud طراحی شدهاند. انبار داده ابری به کلی توسط سرویسهای ابری مدیریت میشود و استفاده از آنها پر از مزیت است. توجه داشته باشید که انبار داده ابری میتواند عملکرد، پشتیبانی، امنیت بالاتری را در اختیار کاربران قرار دهد. همچنین آنها میتوانند انعطافپذیری بالایی داشته باشند. انبار دادههای ابری به اندازه انبار دادههای محلی نیاز به مدیریت پیچیده ندارند.
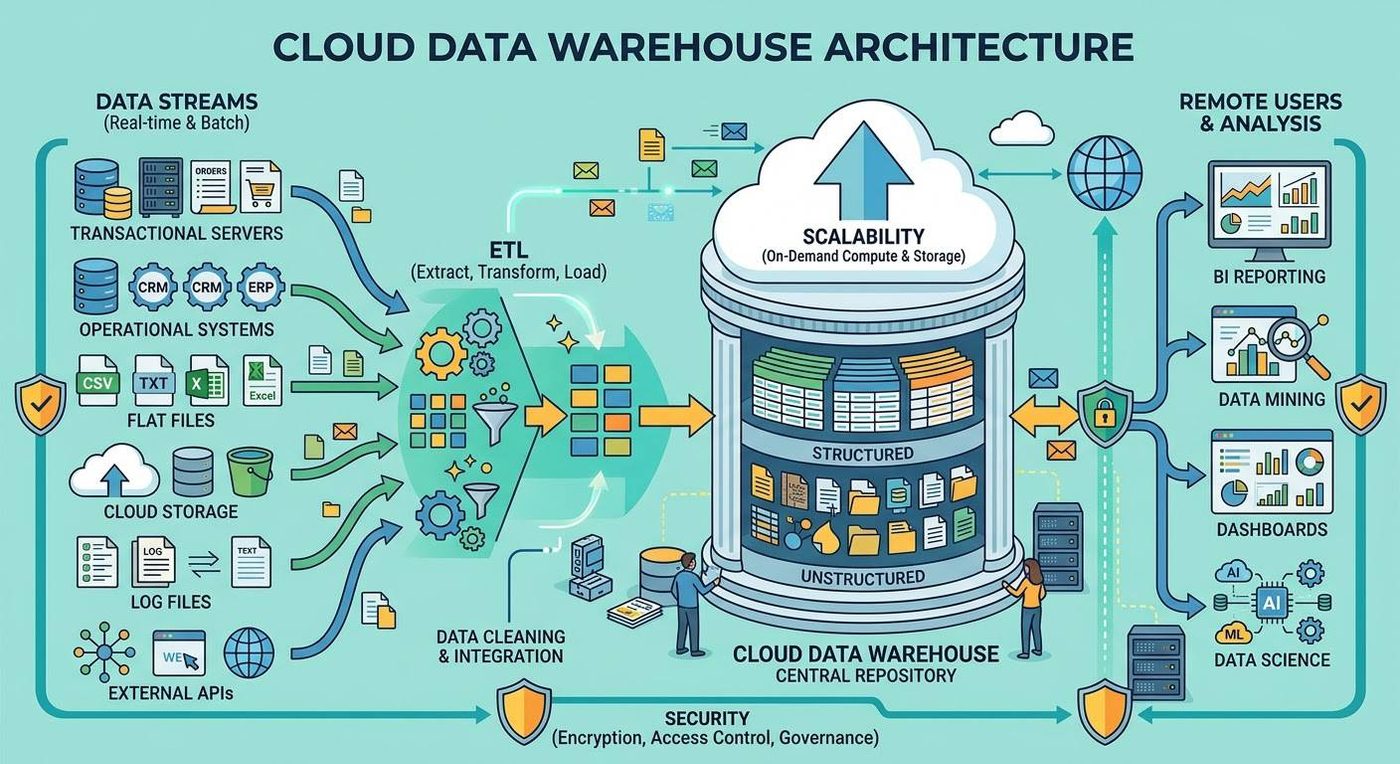
مزایای انبار داده ابری
از مهمترین مزایای انبار داده ابری میتوان به موارد زیر اشاره کرد:
سهولت در استفاده: کاربران میتوانند بدون نیاز به نصب و راهاندازی سختافزار، به انبار داده ابری دسترسی پیدا کنند.
سهولت در مدیریت: انبار داده ابری توسط سرویسدهنده ابری مدیریت میشود، بنابراین سازمان نیازی به استخدام تیم فنی بزرگ ندارد.
صرفهجویی در هزینه: سازمانها فقط برای منابعی که استفاده میکنند هزینه میپردازند، نه برای سختافزار و زیرساخت ثابت.
مقیاسپذیری: انبار داده ابری میتواند به سرعت با نیازهای سازمان رشد کند.
امنیت بالاتر: سرویسدهندگان ابری معمولاً امنیت بالایی را ارائه میدهند.
انبار دادههای ابری به صورت کاملاً اتوماتیک شده و خودکار هستند. توجه داشته باشید که برخی از انبار دادهها به صورت ابری مهاجرت نکردهاند و میتوانند تصمیمهای نهایی کیفیت کارهای همراه با آنها را داشته باشند. استفاده از ایستگاههای ابری، به دنیای انبار داده هزینهای نداشته است. در این انبار دادهها، استفاده از تکنولوژیهای جدید نیز کاهش کارایی پردازشگرها را به همراه دارد.
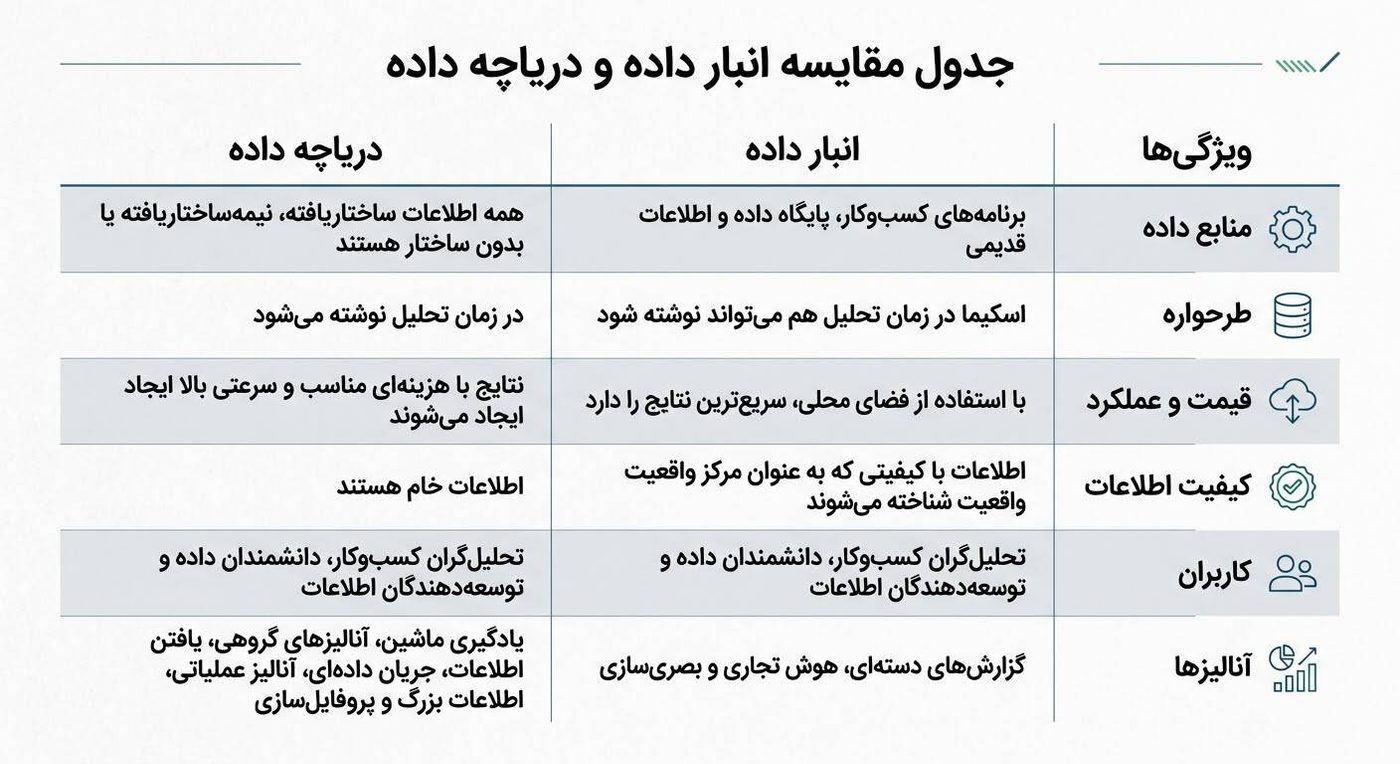
انبار داده، پایگاه داده و دریاچه داده چگونه با هم کار میکنند؟
به صورت کلی، کسبوکارهای مختلف از یک ترکیب مهم استفاده میکنند: ترکیبی از پایگاه داده، دریاچه اطلاعات و انبار داده برای ذخیرهسازی و تجزیه اطلاعات. سیستمهای مدرن میتوانند یکپارچهسازی معماری گفته شده را راحتتر کنند. توجه داشته باشید که با افزایش حجم و تنوع دادهها، دنبال کردن یک الگوی رایج میتواند برای انبار دادههای مختلف مفید باشد.
یک انبار داده برای تجزیه و تحلیل اطلاعاتی ایجاد شده است که فایلهای زیادی را به خود درگیر میکنند. یک پایگاه داده برای جمعآوری و ذخیره دادهها همچون جزئیات یک تراکنش مورد استفاده قرار میگیرد. برخلاف انبار داده، یک دریاچه داده میتواند حاوی مخزنی متمرکز برای همه دادههای ساختاریافته و نیمهساختاریافته و بدون ساختار باشد. به صورت کلی از SQL برای فرمتدهی به اطلاعات در این سیستم استفاده میشود. همه برنامههای موجود در دنیا به هر سه این موارد نیاز خواهند داشت. برخی از برنامهها میتوانند بدون دریاچه هم کار کنند.
جدول مقایسه انبار داده و دریاچه داده
جدول مقایسه انبار داده و پایگاه داده
انبار داده، دیتا مارت و انبار داده عملیاتی
با اینکه این سه مورد ساختار نسبتاً یکسانی دارند، ولی انبار داده، دیتا مارتها و انبار داده عملیاتی، پروسههای متنوعی را در خود جای دادهاند. به صورت کلی یک دیتا مارت عملکردهای کلی انبار داده را در خود جای داده است، ولی محدوده عملکرد آن به شدت محبوب میباشد. یک بخش یا یک خط تجاری را میتوان به عنوان تنها موقعیت عملیاتی این سیستم شناسایی کرد. همین مسئله باعث شده تا دادهها خیلی راحتتر ایجاد شوند. اما با این حال، آنها ناسازگاری سیستم را بیشتر میکنند.
ODS یا انبار دادههای عملیاتی فقط از عملیاتهای روزانه پشتیبانی میکنند. در نتیجه دسترسی آنها نیز محدود میباشد. آنها به عنوان منابع داده فعلی قدرت بالایی دارند.
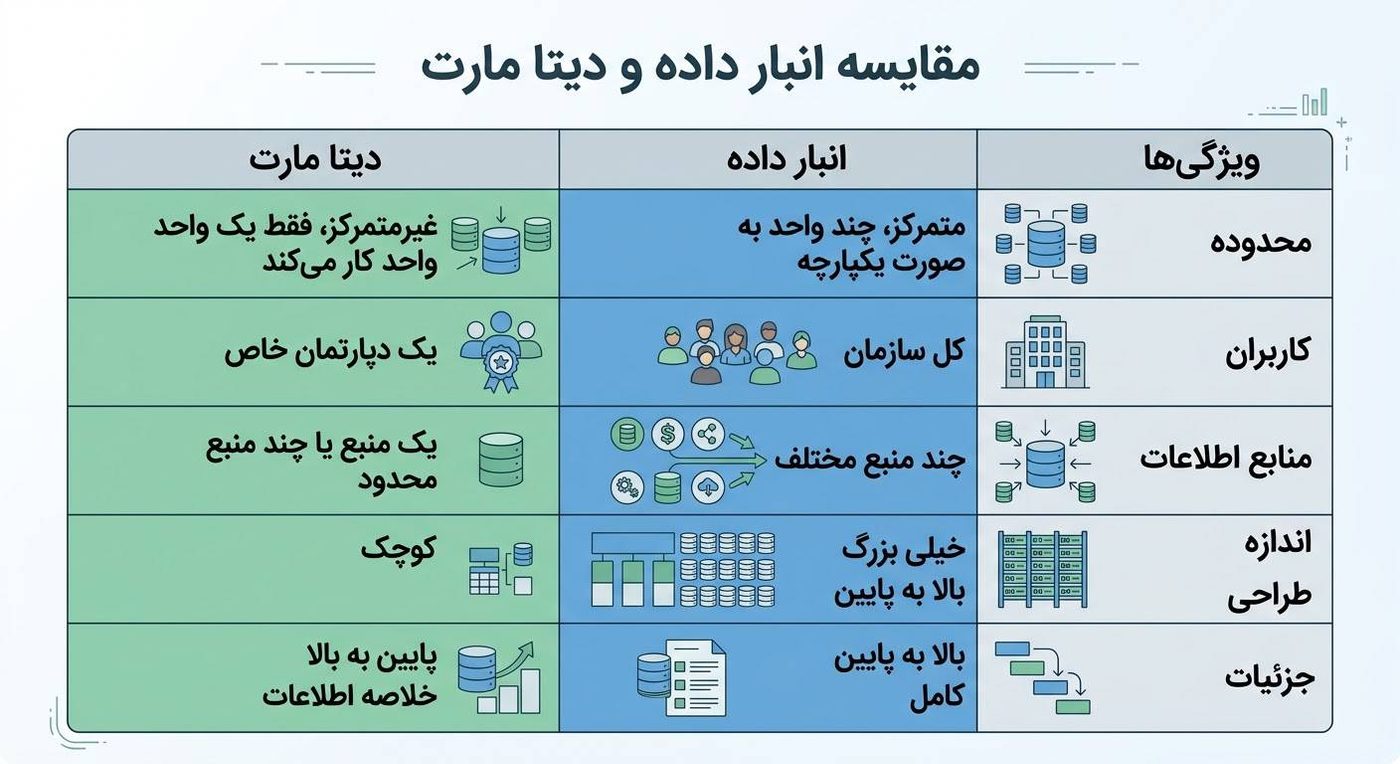
دیتا مارت چگونه با انبار داده مقایسه میشود؟
دیتا مارت در واقع انبار دادهای است که نیازهای یک واحد کسبوکاری یا یک تیم خاص را رفع میکند. تیمهای مالی، بازاریابی و فروش از آن استفاده میکنند. این سیستم کوچکتر است، تمرکز بیشتری دارد و میتواند خلاصههای زیادی از اطلاعات مختلف را در خود جای دهد. دیتا مارت میتواند قسمتی از انبار داده نیز باشد.
جدول مقایسه انبار داده و دیتا مارت
کاربردهای واقعی انبار داده
این سیستم امروزه در صنایع مختلف کاربردهای بسیار متنوعی دارد. در ادامه چند مثال واقعی را بررسی میکنیم:
۱. خردهفروشی و فروشگاههای زنجیرهای
یک فروشگاه زنجیرهای بزرگ مانند والمارت از این راهکار برای تحلیل رفتار خرید مشتریان استفاده میکند. این شرکت میتواند بفهمد که مشتریان در فصل تابستان بیشتر چه محصولاتی میخرند، چه ترکیبهایی از محصولات با هم خریداری میشوند و چه عواملی باعث افزایش فروش میشود. این زیرساخت به والمارت کمک کرده تا موجودی انبار خود را بهینه کند و سودآوری را افزایش دهد.
۲. بانکداری
بانکها از این فناوری برای شناسایی تقلب، ارزیابی ریسک اعتباری و تحلیل رفتار مشتریان استفاده میکنند. مثلاً اگر یک تراکنش مشکوک در حساب یک مشتری انجام شود، این سیستم میتواند با تحلیل الگوهای قبلی، آن را شناسایی کرده و هشدار دهد.
۳. بیمارستانها و مراکز درمانی
مراکز درمانی از این راهکار برای تحلیل سوابق بیماران، بهبود کیفیت درمان و کاهش هزینهها استفاده میکنند. مثلاً میتوانند بفهمند کدام روش درمانی برای یک بیماری خاص مؤثرتر است.
۴. بازاریابی دیجیتال
شرکتهای بازاریابی از این زیرساخت برای تحلیل کمپینهای تبلیغاتی، شناسایی مخاطبان هدف و اندازهگیری بازگشت سرمایه استفاده میکنند.
۵. حملونقل و لجستیک
شرکتهای حملونقل از این سیستم برای بهینهسازی مسیرها، کاهش زمان تحویل و مدیریت ناوگان استفاده میکنند.
۶. آموزش و پرورش
موسسات آموزشی از این فناوری برای تحلیل عملکرد دانشجویان، بهبود کیفیت آموزش و شناسایی دانشجویان در معرض خطر استفاده میکنند.
۷. دولت و سازمانهای عمومی
سازمانهای دولتی از این راهکار برای تحلیل دادههای جمعیتی، بهبود خدمات عمومی و مبارزه با فساد استفاده میکنند.
۸. صنعت بیمه
شرکتهای بیمه از این زیرساخت برای تحلیل ریسک، شناسایی تقلب و قیمتگذاری محصولات استفاده میکنند.
۹. مخابرات
شرکتهای مخابراتی از این سیستم برای تحلیل مصرف مشتریان، بهبود کیفیت خدمات و کاهش ریزش مشتریان استفاده میکنند.
۱۰. تولید و صنعت
کارخانهها از این فناوری برای تحلیل عملکرد تولید، کاهش ضایعات و بهبود کیفیت محصولات استفاده میکنند.
چالشهای انبار داده
با وجود مزایای فراوان، این سیستم با چالشهایی نیز همراه است:
- هزینه بالا: راهاندازی و نگهداری این زیرساخت میتواند هزینهبر باشد، به ویژه برای سازمانهای کوچک.
- پیچیدگی: طراحی و پیادهسازی این راهکار نیازمند تخصص و تجربه بالاست.
- زمانبر بودن: فرآیند ETL میتواند زمانبر باشد، به ویژه وقتی حجم دادهها زیاد است.
- امنیت: حفاظت از دادههای حساس در این سیستم بسیار مهم است و نیازمند تدابیر امنیتی قوی است.
- بهروزرسانی: نگهداری و بهروزرسانی این مخزن مرکزی نیازمند تلاش مستمر است.
- کیفیت دادهها: اگر دادههای ورودی بیکیفیت باشند، خروجیهای این سیستم نیز بیکیفیت خواهند بود.
- مقاومت کاربران: برخی کاربران ممکن است در برابر تغییرات مقاومت کنند و استفاده از این فناوری را نپذیرند.
- یکپارچهسازی: یکپارچهسازی دادهها از منابع مختلف میتواند چالشبرانگیز باشد.
امنیت و حاکمیت داده در انبار داده
امنیت و حاکمیت داده در این سیستم از اهمیت بالایی برخوردار است. این مخزن مرکزی معمولاً حاوی دادههای حساس و حیاتی سازمان است و باید به درستی محافظت شود.
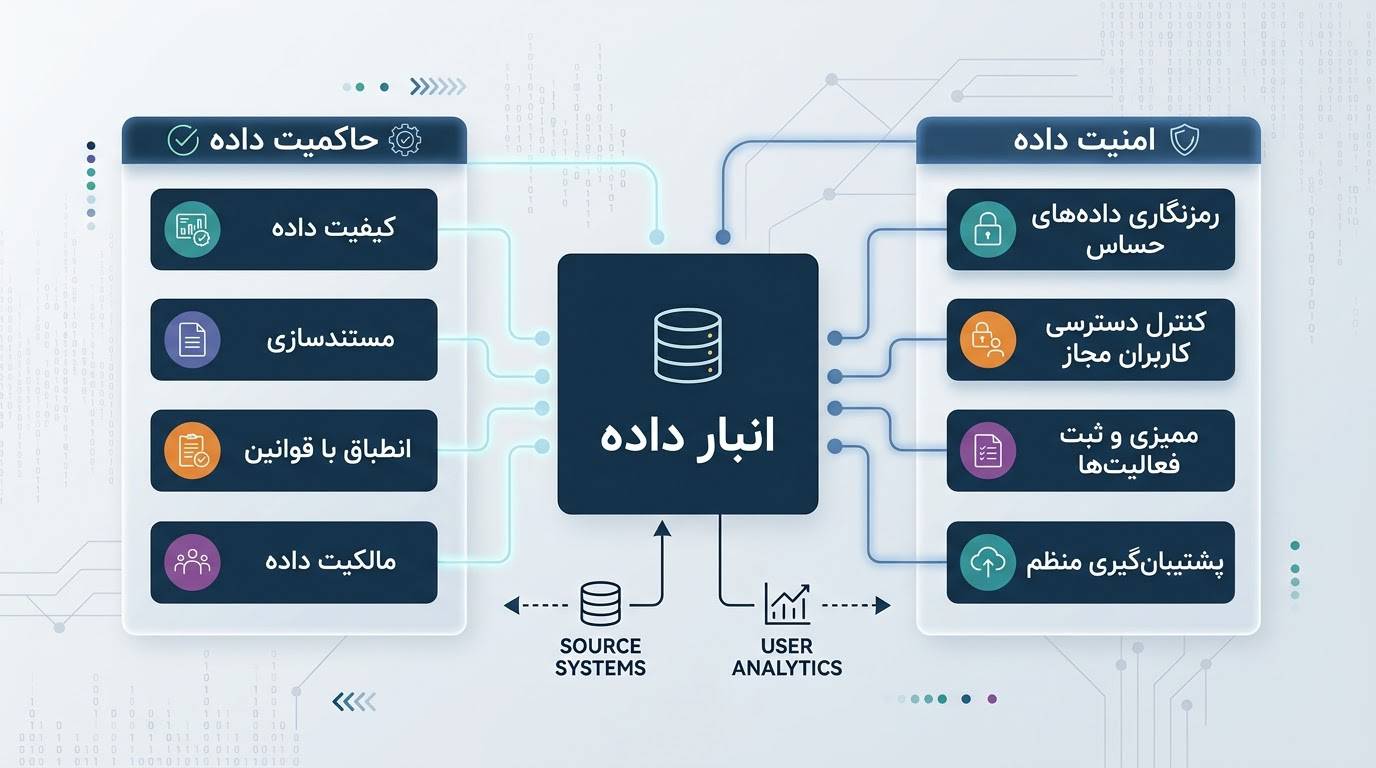
امنیت انبار داده شامل موارد زیر است:
- رمزنگاری: دادههای حساس باید رمزنگاری شوند تا در صورت دسترسی غیرمجاز، قابل خواندن نباشند.
- کنترل دسترسی: فقط کاربران مجاز باید به این سیستم دسترسی داشته باشند.
- ممیزی: تمام فعالیتهای کاربران در این زیرساخت باید ثبت و ممیزی شوند.
- پشتیبانگیری: دادههای این مخزن مرکزی باید به طور منظم پشتیبانگیری شوند.
حاکمیت داده شامل سیاستها و رویههایی است که اطمینان میدهند دادهها به درستی مدیریت میشوند. این شامل موارد زیر است:
- کیفیت داده: اطمینان از صحت، کامل بودن و بهروز بودن دادهها.
- مستندسازی: مستندسازی ساختار این سیستم و فرآیندهای ETL.
- انطباق: اطمینان از رعایت قوانین و مقررات مربوط به دادهها.
- مالکیت داده: تعیین مالکیت دادهها و مسئولیتهای مربوطه.
آینده انبار داده
آینده این راهکار با پیشرفتهای فناوری مانند هوش مصنوعی، یادگیری ماشین و کلاندادهها گره خورده است. نسخههای ابری و مستقل در حال تبدیل شدن به استاندارد جدید هستند. همچنین، اتوماسیون و هوشمندسازی این سیستمها در حال افزایش است. این زیرساختها به سمت یکپارچهسازی بیشتر با سایر سیستمها و ارائه تحلیلهای پیشرفتهتر حرکت میکنند.
روندهای آینده انبار داده
- انبار دادههای ابری: رشد سریع راهکارهای ابری به دلیل انعطافپذیری و مقیاسپذیری.
- هوش مصنوعی و یادگیری ماشین: یکپارچهسازی این سیستم با هوش مصنوعی و یادگیری ماشین برای تحلیلهای پیشرفتهتر.
- اتوماسیون: اتوماسیون فرآیندهای ETL و مدیریت این زیرساخت.
- کلاندادهها: یکپارچهسازی این راهکار با سیستمهای کلانداده.
- اینترنت اشیا: استفاده از این فناوری برای تحلیل دادههای اینترنت اشیا.
- حریم خصوصی داده: افزایش توجه به حریم خصوصی و امنیت دادهها.
نتیجهگیری
این فناوری یکی از ستونهای اصلی هوش تجاری و تحلیل داده در دنیای امروز است. این سیستم به سازمانها کمک میکند دادههای پراکنده خود را یکپارچه کنند، تحلیلهای دقیق انجام دهند و تصمیمهای هوشمندانه بگیرند. این راهکار با ویژگیهایی مانند موضوعمحور بودن، یکپارچگی، پایداری و متغیر بودن با زمان، ابزاری قدرتمند برای مدیران و تحلیلگران است.
از طرفی، نسخههای ابری و مستقل نسل جدیدی از این فناوری هستند که انعطافپذیری و کارایی را افزایش دادهاند. مقایسه این سیستم با پایگاه داده، دریاچه داده و دیتا مارت نشان میدهد که هر کدام نقش خاص خود را در اکوسیستم داده ایفا میکنند.
اگر شما هم به دنبال رشد و توسعه کسبوکار خود هستید، سرمایهگذاری روی این زیرساخت میتواند یکی از هوشمندانهترین تصمیمهای شما باشد. این راهکار به شما کمک میکند تا از دادههای خود ارزش واقعی بسازید و در بازار رقابتی پیشتاز باشید.
سوالات متداول
تفاوت اصلی این سیستم با پایگاه دادههای معمولی که هر روز از آنها استفاده میکنیم، در چیست؟
پایگاه دادههای معمولی برای انجام عملیات روزانه مانند ثبت سفارش، بهروزرسانی موجودی یا حذف یک رکورد طراحی شدهاند. این سیستمها معمولاً با حجم بالایی از عملیات کوچک و سریع سر و کار دارند. اما انبار داده برای تحلیل و گزارشگیری ساخته شده است.
در این سیستم، دادهها یکبار وارد میشوند و سپس بارها مورد تحلیل قرار میگیرند. به همین دلیل، ساختار آن با پایگاه داده معمولی متفاوت است و از ساختارهایی مانند اسکیمای ستارهای استفاده میکند که برای تحلیل سریع بهینه شدهاند.
چرا سازمانها به جای اینکه دادهها را در همان سیستمهای اولیه نگه دارند، به فکر راهاندازی یک مخزن مرکزی میافتند؟
وقتی دادهها در سیستمهای مختلف پراکنده باشند، تحلیل آنها بسیار دشوار و زمانبر میشود. مثلاً فرض کنید یک بانک دادههای مشتریان را در یک سیستم، تراکنشها را در سیستم دیگر و وامها را در سیستم سوم ذخیره میکند.
اگر مدیر بخواهد بداند کدام مشتریان هم وام دارند و هم حساب پسانداز، باید دادهها را از چندین سیستم استخراج و دستی ترکیب کند که احتمال خطا بسیار بالا میرود. یک مخزن مرکزی همه این دادهها را یکجا جمع میکند، آنها را یکپارچه و تمیز میسازد و تحلیل را بسیار سادهتر میکند.
فرآیند ETL دقیقاً چه کاری انجام میدهد و چرا بدون آن، تحلیل دادهها امکانپذیر نیست؟
ETL مخفف سه مرحله است: استخراج (Extract)، تبدیل (Transform) و بارگذاری (Load). در مرحله استخراج، دادهها از منابع مختلف مانند پایگاههای داده، فایلهای متنی و APIها جمعآوری میشوند. در مرحله تبدیل، دادهها تمیز میشوند، فرمتهای مختلف به یک فرمت واحد تبدیل میشوند و دادههای ناقص اصلاح میشوند. در مرحله بارگذاری، دادههای آمادهشده در مخزن مرکزی بارگذاری میشوند. بدون این فرآیند، دادههای خام و پراکنده نمیتوانند به تحلیلهای دقیق و قابل اعتماد تبدیل شوند.
آیا برای راهاندازی این سیستم، حتماً باید از سختافزارهای گرانقیمت و زیرساختهای پیچیده استفاده کرد؟
خیر، امروزه با گسترش فناوریهای ابری، سازمانها میتوانند بدون نیاز به خرید سختافزار گرانقیمت، از سرویسهای ابری استفاده کنند. در این مدل، سازمان فقط برای منابعی که استفاده میکند هزینه میپردازد و نیازی به مدیریت زیرساخت ندارد. این موضوع به ویژه برای کسبوکارهای کوچک و متوسط بسیار مناسب است، زیرا هزینههای راهاندازی و نگهداری را به طور چشمگیری کاهش میدهد.
دیتا مارت چه تفاوتی با یک انبار داده کامل دارد و چه زمانی بهتر است از آن استفاده کنیم؟
دیتا مارت در واقع نسخه کوچکتر و متمرکزتر انبار داده است که فقط نیازهای یک واحد کسبوکاری یا یک تیم خاص را برآورده میکند. مثلاً تیم مالی ممکن است یک دیتا مارت مخصوص خود داشته باشد که فقط دادههای مالی را در بر میگیرد.
دیتا مارت کوچکتر، سریعتر و کمهزینهتر است، اما محدوده عملکرد آن محدودتر است. اگر سازمان شما فقط به تحلیل یک بخش خاص نیاز دارد، دیتا مارت گزینه مناسبتری است. اما اگر نیاز به تحلیل یکپارچه کل سازمان دارید، باید از یک انبار داده کامل استفاده کنید.
اگر دادههای ورودی کیفیت لازم را نداشته باشند، چه اتفاقی برای خروجیهای تحلیلی میافتد؟
اگر دادههای ورودی ناقص، تکراری یا نادرست باشند، خروجیهای تحلیلی نیز بیکیفیت خواهند بود. این موضوع به اصل «زباله وارد کن، زباله بیرون بیاور» معروف است. به همین دلیل، فرآیند ETL اهمیت زیادی دارد، زیرا دادهها را تمیز و یکپارچه میسازد. بدون تمیزکاری دادهها، تحلیلها ممکن است نتایج نادرستی تولید کنند که منجر به تصمیمهای اشتباه شود. بنابراین، کیفیت دادههای ورودی یکی از مهمترین عوامل موفقیت هر سیستم تحلیلی است.
آیا کسبوکارهای کوچک و متوسط هم میتوانند از این فناوری بهرهمند شوند یا فقط مخصوص سازمانهای بزرگ است؟
خیر، این فناوری فقط مخصوص سازمانهای بزرگ نیست. با گسترش راهکارهای ابری و کاهش هزینهها، کسبوکارهای کوچک و متوسط نیز میتوانند از آن بهرهمند شوند. برای کسبوکارهای کوچک، معمولاً استفاده از سرویسهای ابری مقرونبهصرفهتر است، زیرا نیازی به سرمایهگذاری اولیه زیاد ندارند. حتی یک فروشگاه اینترنتی کوچک میتواند با استفاده از این سیستم، رفتار خرید مشتریان خود را تحلیل کند و فروش خود را افزایش دهد.
با توجه به رشد هوش مصنوعی، آیا انبار داده همچنان جایگاه خود را حفظ خواهد کرد یا بهزودی جایگزین میشود؟
انبار داده جایگاه خود را حفظ خواهد کرد، اما نقش آن تغییر میکند. هوش مصنوعی و یادگیری ماشین به تحلیلهای پیشرفتهتر و پیشبینیهای دقیقتر کمک میکنند، اما همچنان به دادههای تمیز، یکپارچه و تاریخی نیاز دارند که توسط انبار داده فراهم میشود. در واقع، انبار داده به عنوان پایه و زیرساخت اصلی برای هوش مصنوعی عمل میکند. بنابراین، به جای جایگزینی، این دو فناوری با یکدیگر یکپارچه میشوند و تحلیلهای قدرتمندتری را ممکن میسازند.
Have any thoughts?
Share your reaction or leave a quick response — we’d love to hear what you think!
-
 0
- 0
- 0
- 0
- 0
- 0


