در این مقاله، مسئله کشف ناهنجاری در بلاکچین و تشخیص تراکنشهای مشکوک در بلاکچین از دیدگاه علم داده بررسی میشود. ابتدا ویژگیهای آماری دادههای آنچین و چالشهای تحلیل آنها معرفی میشوند؛ سپس معماری ترکیبی مبتنی بر قوانین، یادگیری ماشین و تحلیل گراف بررسی خواهد شد. در ادامه، الگوریتم Isolation Forest، دیتاست Elliptic، مسئله Concept Drift و نتایج آزمایشهای زمانی مورد بحث قرار میگیرند و در نهایت، نقشه راه توسعه یک سامانه هوشمند و تطبیقپذیر برای پایش تراکنشهای بلاکچینی ارائه میشود.
فهرست محتوا
مقدمه
فناوری بلاکچین تنها یک زیرساخت برای انتقال دارایی دیجیتال نیست؛ بلکه یک منبع عظیم و دائماً در حال رشد از دادههای تراکنشی است. هر تراکنش ثبتشده روی یک شبکه عمومی میتواند اطلاعاتی درباره زمان انتقال، مقدار دارایی، فرستنده، گیرنده، هزینه تراکنش و ارتباط آن با سایر تراکنشها در اختیار تحلیلگر قرار دهد.
این ویژگی، بلاکچین را به محیطی بسیار جذاب برای علم داده، تحلیل آماری، یادگیری ماشین و تحلیل شبکه تبدیل کرده است. در عین حال، همین ساختار ویژگیهای منحصربهفردی دارد که تحلیل آن را از تحلیل دادههای سنتی مالی متفاوت میکند.
در سیستمهای مالی متعارف، اطلاعات تراکنشها معمولاً در کنار دادههای هویتی و اطلاعاتی مانند مشخصات مشتری، سابقه حساب، اطلاعات KYC، محل فعالیت و سایر متادیتاها قرار میگیرند. اما در بسیاری از شبکههای بلاکچینی، تحلیلگر در ابتدا با مجموعهای از آدرسها و تراکنشها مواجه است که الزاماً هویت واقعی صاحبان آنها را مشخص نمیکنند.
به همین دلیل، سؤال اصلی در بسیاری از سناریوهای تحلیل بلاکچین از: «این تراکنش متعلق به چه فردی است؟» به سمت: «این آدرس چگونه رفتار میکند و این رفتار چه ارتباطی با سایر آدرسها دارد؟» تغییر میکند.
این تغییر دیدگاه در کشف ناهنجاری در بلاکچین، اهمیت Behavioral Analytics را افزایش داده است. در این رویکرد، بهجای تکیه صرف بر هویت، رفتار تراکنشی، الگوهای زمانی، حجم انتقال، تعداد تعاملات، ساختار شبکه و تغییرات رفتاری در طول زمان مورد بررسی قرار میگیرد.
از طرف دیگر، فعالیتهای مشکوک در بلاکچین معمولاً بخش کوچکی از کل تراکنشها را تشکیل میدهند. بنابراین مسئله با عدم توازن شدید کلاسها مواجه است. یک مدل ممکن است با پیشبینی اکثر تراکنشها بهعنوان «مشروع»، Accuracy بالایی داشته باشد، اما در تشخیص موارد واقعاً مشکوک عملکرد ضعیفی ارائه دهد.
چالش مهم دیگر، پویایی این دادههاست. رفتار کاربران، شرایط بازار، ساختار شبکه و حتی روشهای مورد استفاده برای جابهجایی دارایی میتوانند در طول زمان تغییر کنند. بنابراین مدلی که بر اساس دادههای گذشته عملکرد مناسبی داشته است، لزوماً در آینده نیز همان سطح از کارایی را حفظ نخواهد کرد.
این مسئله با مفهوم Concept Drift شناخته میشود و یکی از مهمترین چالشهای طراحی سامانههای هوشمند پایش بلاکچین است.
دادههای بلاکچین از منظر علم داده
برای درک مسئله تشخیص تراکنشهای مشکوک، ابتدا باید ماهیت دادههای بلاکچین را شناخت.
دادههای آنچین یا On-Chain Data مجموعهای از دادههایی هستند که مستقیماً از فعالیت ثبتشده روی یک شبکه بلاکچینی به دست میآیند. بسته به نوع شبکه و روش استخراج داده، این اطلاعات میتوانند شامل آدرس فرستنده و گیرنده، مقدار انتقال، زمان تراکنش، کارمزد، وضعیت تراکنش، قرارداد هوشمند مورد تعامل و سایر ویژگیهای مرتبط باشند. از منظر علم داده، چنین مجموعهای فقط یک جدول ساده از تراکنشها نیست. این دادهها همزمان دارای سه ویژگی مهم هستند:
- ویژگیهای مقطعی
- ویژگیهای زمانی
- ویژگیهای شبکهای
برای مثال، مقدار یک تراکنش یک ویژگی مقطعی است؛ فاصله زمانی میان دو تراکنش یک ویژگی زمانی محسوب میشود؛ و ارتباط یک آدرس با دهها آدرس دیگر یک ویژگی شبکهای است. بنابراین تحلیل حرفهای بلاکچین نیازمند ترکیب چند نوع نگاه به داده است.
شبهناشناسی و نبود متادیتای هویتی
یکی از تفاوتهای مهم بلاکچین با بسیاری از سیستمهای مالی سنتی، مفهوم Pseudonymity یا شبهناشناسی است. آدرس یک کیف پول الزاماً نام، کد ملی، شماره شرکت یا سایر مشخصات واقعی صاحب آن را در اختیار تحلیلگر قرار نمیدهد
این ویژگی دو پیامد مهم دارد. نخست اینکه مدلهای یادگیری ماشین نمیتوانند مانند بسیاری از مسائل سنتی مالی از ویژگیهای جمعیتشناختی استفاده کنند. دوم اینکه اهمیت ویژگیهای رفتاری افزایش پیدا میکند.
برای نمونه، بهجای آنکه صرفاً بدانیم «این آدرس متعلق به چه کسی است»، میتوانیم بررسی کنیم:
- در چه ساعاتی فعالیت میکند؟
- معمولاً چه مقدار دارایی انتقال میدهد؟
- با چند آدرس ارتباط دارد؟
- فاصله زمانی میان تراکنشهای آن چقدر است؟
- چه مقدار دارایی دریافت و چه مقدار ارسال میکند؟
- آیا رفتار آن در یک بازه زمانی تغییر کرده است؟
- آیا با مجموعه خاصی از آدرسها ارتباط غیرمعمول دارد؟
این نوع تحلیل را میتوان در چارچوب Behavioral Analytics قرار داد.
چرا کشف تراکنش مشکوک یک مسئله ساده طبقهبندی نیست؟
در نگاه اول ممکن است مسئله به شکل یک Classification Problem تعریف شود:
تراکنش → مشروع یا غیرمشروع
اما در عمل، این مدلسازی بسیار سادهسازیشده است.
سه چالش مهم وجود دارد:
چالش اول: همه تراکنشها برچسب ندارند
برای بسیاری از تراکنشها نمیتوان بهصورت قطعی گفت که رفتار مشروع یا غیرمشروع دارند.
چالش دوم: رفتار مشکوک ممکن است تغییر کند
الگویی که امروز غیرعادی محسوب میشود ممکن است در آینده تغییر کند.
چالش سوم: نمونههای مشکوک نادر هستند
در بسیاری از دادههای مالی، تعداد نمونههای غیرعادی نسبت به نمونههای عادی بسیار کمتر است.
به همین دلیل، در کشف ناهنجاری در بلاکچین، در کنار Supervised Learning، روشهای Unsupervised Anomaly Detection نیز اهمیت پیدا میکنند.
عدم توازن کلاسها و اهمیت معیارهای ارزیابی
فرض کنید از میان یک میلیون تراکنش، تنها چند هزار تراکنش بهعنوان نمونههای مثبت یا پرریسک شناسایی شده باشند. اگر در کشف ناهنجاری در بلاکچین مدلی همه تراکنشها را مشروع اعلام کند، ممکن است Accuracy آن ظاهراً بسیار بالا باشد. اما چنین مدلی در واقع هیچ ارزش عملی برای کشف نمونههای نادر ندارد. به همین دلیل در مسائل کشف تقلب، AML و تشخیص ناهنجاری، معیارهای مختلفی باید در کنار هم بررسی شوند.
Precision
Precision نشان میدهد از میان مواردی که مدل بهعنوان مثبت شناسایی کرده است، چه نسبتی واقعاً مثبت بودهاند.
Recall
Recall نشان میدهد مدل چه نسبتی از نمونههای واقعاً مثبت را پیدا کرده است.
در بسیاری از سامانههای کشف ریسک، Recall اهمیت ویژهای دارد؛ زیرا از دست دادن یک مورد پرریسک میتواند هزینه زیادی داشته باشد.
F1-Score
F1 میان Precision و Recall نوعی تعادل ایجاد میکند و زمانی مفید است که هر دو معیار اهمیت داشته باشند.
ROC-AUC
ROC-AUC توانایی مدل در تفکیک دو کلاس را در آستانههای مختلف ارزیابی میکند.
با این حال، در مسائل بسیار نامتوازن، بررسی معیارهایی مانند PR-AUC نیز میتواند اطلاعات مفیدتری درباره عملکرد مدل ارائه کند. بنابراین ارزیابی یک سامانه تشخیص تراکنش مشکوک نباید تنها بر Accuracy تکیه کند.
رفتارهای نادر و توزیعهای Heavy-Tailed
یکی دیگر از ویژگیهای مهم دادههای مالی و بلاکچینی، وجود مقادیر بسیار متفاوت در متغیرهایی مانند حجم انتقال است. ممکن است تعداد بسیار زیادی تراکنش با مقدار نسبتاً پایین وجود داشته باشد و در مقابل، تعداد بسیار کمی تراکنش با مقدار بسیار بالا ثبت شوند. در چنین شرایطی، میانگین بهتنهایی ممکن است تصویر دقیقی از رفتار معمول ارائه نکند.
برای مثال، اگر یک آدرس معمولاً تراکنشهایی با مقدار مشخص انجام دهد و ناگهان تراکنشی چندین برابر بزرگتر ثبت کند، این تراکنش ممکن است از نظر آماری یک Outlier باشد.
اما باز هم باید تأکید کرد:
Outlier بودن با مشکوک یا مجرمانه بودن یکسان نیست.
ممکن است یک شرکت یا صرافی در شرایط خاص یک تراکنش بسیار بزرگ انجام دهد و این رفتار کاملاً مشروع باشد. بنابراین بهترین روش برای کشف ناهنجاری در بلاکچین، مقایسه رفتار مشاهدهشده با Baseline رفتاری مناسب است.
این Baseline میتواند بر اساس:
- تاریخچه همان آدرس
- گروه مشابهی از آدرسها
- نوع فعالیت
- بازه زمانی
- یا سایر ویژگیهای زمینهای
تعریف شود.
اهمیت زمان در تحلیل تراکنشهای بلاکچینی
تراکنشها رویدادهایی مستقل از زمان نیستند. دو تراکنش مشابه که در فاصله زمانی چند روز انجام شوند ممکن است رفتار متفاوتی را نشان دهند؛ در حالی که انجام همان دو تراکنش در فاصله چند ثانیه میتواند سیگنال متفاوتی ایجاد کند. به همین دلیل، ویژگیهایی مانند:
- فاصله زمانی تراکنشها
- تعداد تراکنش در یک بازه زمانی
- سرعت انتقال
- تغییر ناگهانی در فعالیت
- الگوهای Burst
- تغییرات کارمزد
میتوانند برای مدلهای تحلیلی اهمیت داشته باشند. این مسئله نشان میدهد که کشف ناهنجاری در بلاکچین را نمیتوان همیشه به یک جدول ایستا تقلیل داد.
معماری چندلایه برای تشخیص تراکنشهای مشکوک
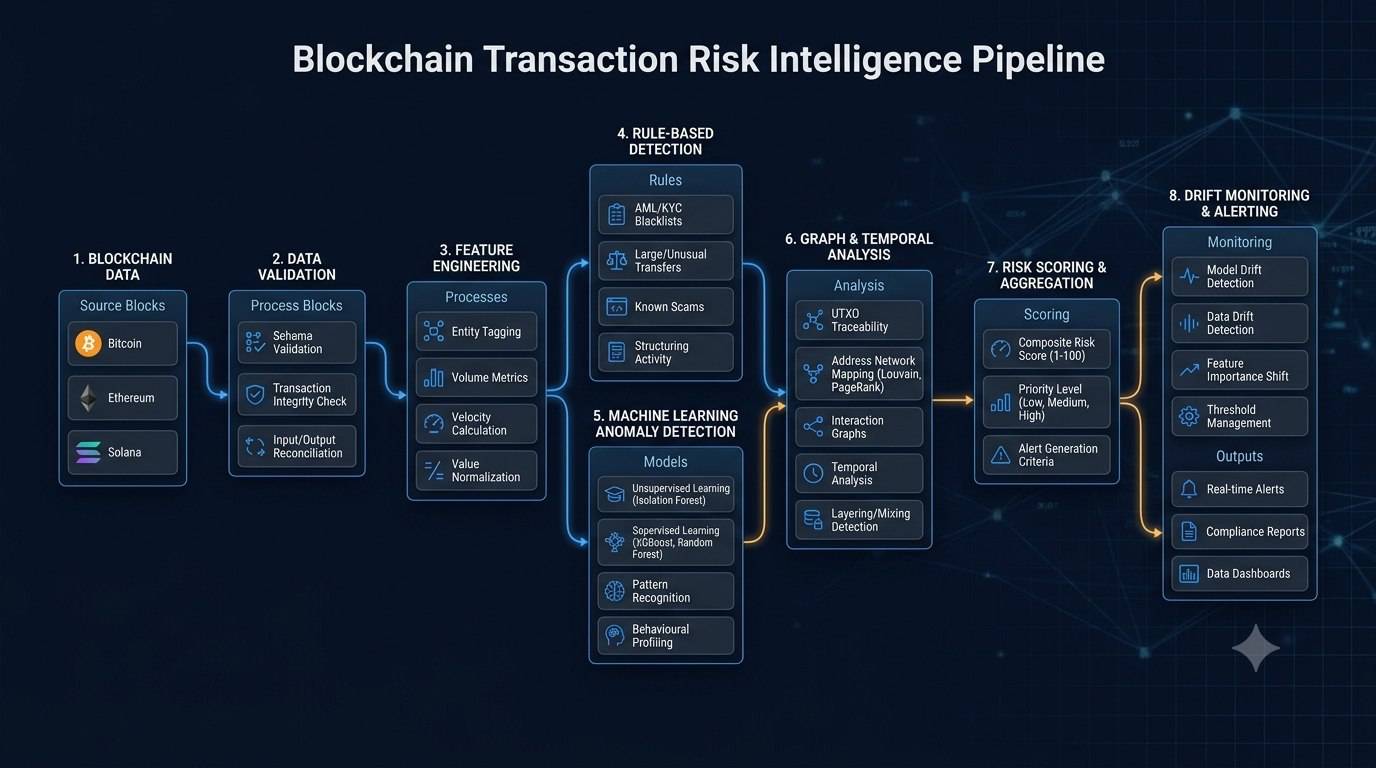
با توجه به پیچیدگی کشف ناهنجاری در بلاکچین، استفاده از یک الگوریتم واحد معمولاً بهترین راهکار نیست. یک معماری چندلایه میتواند از روشهای مختلف برای تولید شواهد و سیگنالهای ریسک استفاده کند.
نمای کلی این معماری را میتوان چنین تصور کرد:
Blockchain Data
↓
Data Validation & Feature Engineering
↓
Rule-Based Detection
↓
Machine Learning Anomaly Detection
↓
Graph & Temporal Analysis
↓
Risk Scoring
↓
Alerting & Reporting
این معماری اجازه میدهد هر روش وظیفه مشخصی داشته باشد. موتور قوانین برای رفتارهای از پیش شناختهشده مناسب است. یادگیری ماشین برای کشف الگوهای پیچیدهتر و ناهنجاریهای ناشناخته مفید است. تحلیل گراف برای درک روابط میان آدرسها استفاده میشود. و لایه Risk Scoring میتواند سیگنالهای مختلف را برای اولویتبندی موارد نیازمند بررسی ترکیب کند.
موتور قوانین؛ ساده، سریع و قابل توضیح
Rule-Based Detection یکی از قدیمیترین و در عین حال کاربردیترین روشهای کشف ناهنجاری در بلاکچین است. در این روش، متخصصان بر اساس دانش دامنه مجموعهای از قواعد را تعریف میکنند. مزیت اصلی این روش تفسیرپذیری است. اگر یک تراکنش به دلیل قانون مشخصی علامتگذاری شود، سیستم میتواند توضیح دهد که کدام قانون فعال شده است. این ویژگی در محیطهایی که قابلیت توضیح تصمیم اهمیت دارد، ارزشمند است.
قانون انتقال با حجم غیرعادی
فرض کنید رفتار معمول یک آدرس شامل انتقالهایی در محدوده مشخصی باشد. اگر ناگهان مقدار یک تراکنش بهشدت از الگوی قبلی فاصله بگیرد، سیستم میتواند آن را بهعنوان یک Signal ثبت کند.
در سادهترین حالت میتوان از Z-Score استفاده کرد:
Z = (X − μ) / σ
اما در دادههایی با توزیعهای شدیداً نامتقارن، استفاده مستقیم از میانگین و انحراف معیار ممکن است بهترین گزینه نباشد. در این موارد، معیارهایی مانند Median، IQR یا تبدیل لگاریتمی نیز میتوانند بررسی شوند.
تراکنشهای سریع و Burst Activity
افزایش ناگهانی تعداد تراکنشها میتواند یکی دیگر از سیگنالهای رفتاری باشد. برای مثال، اگر یک آدرس در حالت معمول روزانه تعداد محدودی تراکنش انجام دهد اما در چند دقیقه تعداد زیادی تراکنش ثبت کند، این تغییر رفتار میتواند برای بررسی بیشتر علامتگذاری شود. البته چنین رفتاری نیز الزاماً غیرقانونی نیست.
برای مثال، یک سرویس مالی یا قرارداد هوشمند ممکن است در شرایط خاص بهصورت خودکار تعداد زیادی تراکنش ایجاد کند. بنابراین در کشف ناهنجاری در بلاکچین بهتر است Burst Activity بهعنوان یک Feature یا Risk Signal استفاده شود، نه یک حکم قطعی.
الگوهای Fan-In و Fan-Out
یکی از ویژگیهای ارزشمند تحلیل بلاکچین، امکان مشاهده جریان دارایی میان تعداد زیادی آدرس است. در الگوی Fan-Out، یک آدرس با تعداد زیادی مقصد ارتباط برقرار میکند. بهصورت مفهومی:
A → B
A → C
A → D
A → E
در مقابل، Fan-In زمانی رخ میدهد که تعداد زیادی آدرس به یک مقصد مشخص دارایی منتقل کنند:
B → A
C → A
D → A
E → A
این الگوها در کاربردهای مختلفی میتوانند کاملاً مشروع باشند؛ بنابراین استفاده از آنها باید در کنار سایر ویژگیها صورت گیرد. ترکیب Fan-In و Fan-Out، تعداد تراکنشها، فاصله زمانی و حجم انتقال در کشف ناهنجاری در بلاکچین میتواند اطلاعات بسیار بیشتری نسبت به بررسی یک تراکنش منفرد ارائه دهد.
تعامل با آدرسهای پرریسک
یکی دیگر از سیگنالهای قابل استفاده، تعامل با آدرسهایی است که در منابع معتبر بهعنوان پرریسک شناسایی شدهاند. در چنین حالتی سیستم میتواند:
- تعامل مستقیم
- شدت تعامل
- تعداد تراکنشها
- مقدار دارایی منتقلشده
- و فاصله گرافی
را بررسی کند.
اما یک اصل مهم باید رعایت شود:
ارتباط با یک آدرس پرریسک، بهتنهایی اثباتکننده رفتار مجرمانه نیست.
ممکن است یک آدرس مشروع، بدون اطلاع از ماهیت واقعی طرف مقابل، با یک آدرس پرریسک تعامل داشته باشد.
بنابراین در کشف ناهنجاری در بلاکچین، Blacklist باید بهعنوان یک سیگنال تحلیلی وارد موتور ریسک شود.
Gas و رفتار تراکنشی
در شبکههای مبتنی بر ماشین مجازی اتریوم، اطلاعات مربوط به Gas میتواند یکی از ویژگیهای تحلیل باشد.
مواردی مانند:
- Gas Price
- Gas Used
- نسبت Gas به مقدار انتقال
- تغییرات ناگهانی هزینه تراکنش
ممکن است اطلاعات رفتاری ارائه کنند. اما تفسیر این دادهها نیز باید با زمینه شبکه انجام شود. افزایش Gas Price ممکن است ناشی از ازدحام شبکه یا تمایل مشروع کاربر برای اولویتبندی تراکنش باشد. بنابراین:
Abنرمال Gas ≠ Malicious Transaction
بلکه:
Abنرمال Gas → Risk Signal
است.
یادگیری ماشین و کشف ناهنجاری
موتور قوانین برای کشف ناهنجاری در بلاکچین زمانی عملکرد خوبی دارد که رفتار موردنظر از قبل شناخته شده باشد. اما رفتارهای جدید همیشه با قوانین موجود قابل شناسایی نیستند. در اینجا روشهای Machine Learning و بهخصوص Anomaly Detection اهمیت پیدا میکنند. هدف این الگوریتمها، شناسایی مشاهدههایی است که نسبت به الگوی عمومی دادهها تفاوت محسوسی دارند. در روشهای بدون نظارت، مدل الزاماً به برچسب دقیق همه تراکنشها نیاز ندارد. این ویژگی برای محیطهایی که داده برچسبخورده محدود است، ارزشمند است.
Isolation Forest و کشف نقاط غیرعادی
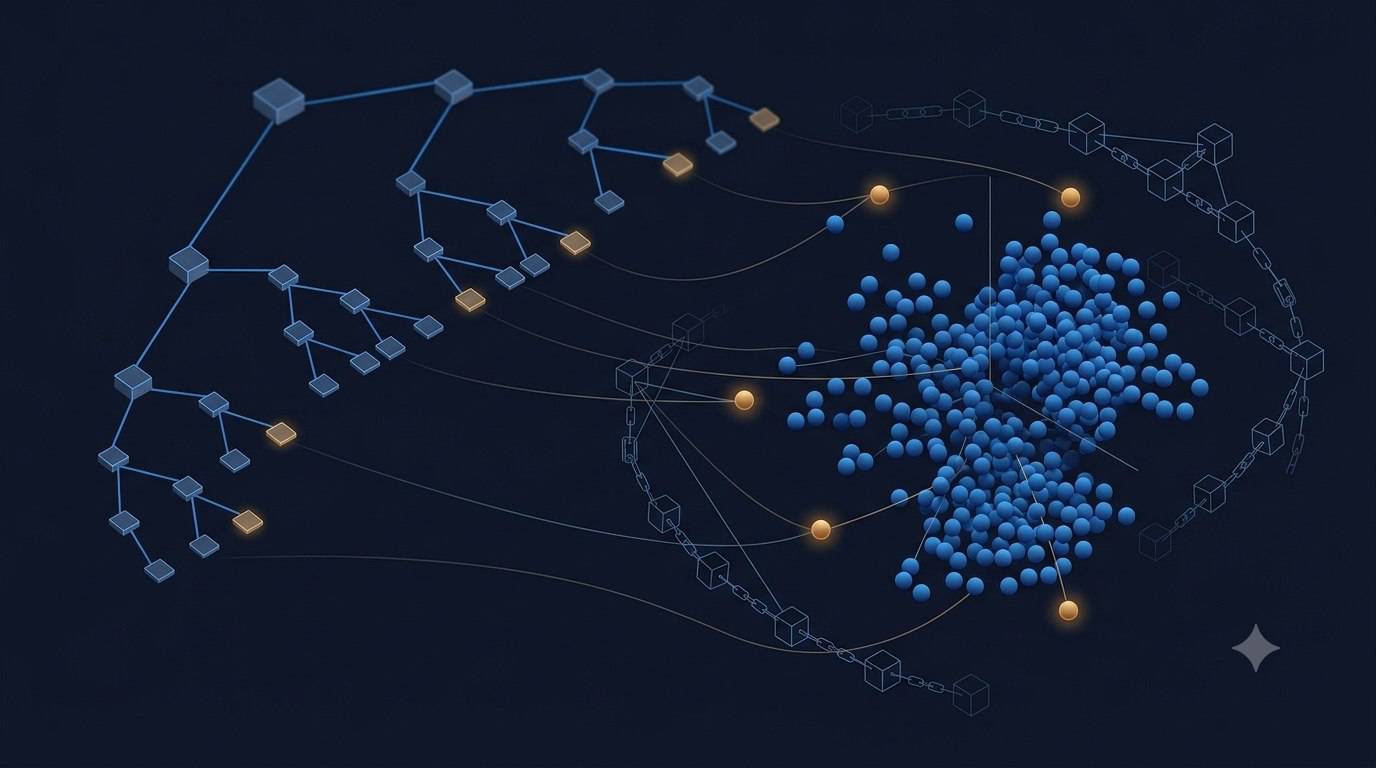
Isolation Forest یکی از الگوریتمهای شناختهشده برای کشف ناهنجاری است. ایده بنیادی الگوریتم بر یک اصل ساده است:
نمونههای غیرعادی معمولاً راحتتر از نمونههای عادی از سایر دادهها جدا میشوند.
مدل با استفاده از تقسیمبندیهای تصادفی، دادهها را در ساختارهایی شبیه درخت قرار میدهد. اگر یک مشاهده ویژگیهای بسیار متفاوتی نسبت به سایر دادهها داشته باشد، احتمال دارد با تعداد تقسیمهای کمتری ایزوله شود. در نتیجه میتوان برای آن یک نمره ناهنجاری محاسبه کرد.
ویژگیهای مناسب برای مدل
برای استفاده از Isolation Forest در تحلیل تراکنشهای بلاکچین، میتوان ویژگیهایی مانند موارد زیر را بررسی کرد:
ویژگیهای مالی
- مقدار انتقال
- لگاریتم مقدار انتقال
- تغییر مقدار نسبت به سابقه
- نسبت کارمزد به مقدار انتقال
ویژگیهای زمانی
- فاصله زمانی از تراکنش قبلی
- تعداد تراکنش در بازه زمانی
- میانگین فاصله زمانی
- تغییر سرعت فعالیت
ویژگیهای رفتاری
- تعداد گیرندگان
- تعداد فرستندگان
- تعداد آدرسهای منحصربهفرد
- تغییر الگوی فعالیت
ویژگیهای شبکهای
- In-Degree
- Out-Degree
- Fan Ratio
- Clustering
- Centrality
در اینجا مرحله Feature Engineering اهمیت بسیار زیادی دارد. یک الگوریتم متوسط با ویژگیهای مناسب میتواند عملکرد بهتری از یک الگوریتم پیچیده با ویژگیهای ضعیف داشته باشد.
محدودیتهای Isolation Forest
Isolation Forest نیز مانند هر الگوریتم دیگری محدودیت دارد. مهمترین مسئله در کشف ناهنجاری در بلاکچین این است که:
هر رفتار غیرعادی الزاماً رفتار مجرمانه نیست.
مدل ممکن است یک تراکنش مشروع را به دلیل نادر بودن علامتگذاری کند. از سوی دیگر، اگر یک رفتار غیرعادی در داده آموزشی یا داده مرجع مدل بهاندازه کافی دیده شود، ممکن است دیگر بهعنوان ناهنجاری شناسایی نشود. بنابراین انتخاب داده، تعریف Baseline و بهروزرسانی مدل اهمیت زیادی دارد.
چرا Anomaly Score نباید بهعنوان اثبات جرم تفسیر شود؟
این نکته در کشف ناهنجاری در بلاکچین از نظر علمی و عملی بسیار مهم است. فرض کنیم مدل یک تراکنش را با Anomaly Score بالا علامتگذاری کرده است. این خروجی تنها میگوید:
رفتار تراکنش نسبت به الگوی داده مورد استفاده برای مدل، غیرعادیتر است.
اما نمیگوید:
این تراکنش قطعاً مجرمانه است.
برای رسیدن به یک ارزیابی قابل اتکاتر، باید سیگنالهای دیگری مانند:
- قواعد از پیش تعریفشده
- سابقه آدرس
- ارتباطات گرافی
- رفتار زمانی
- دادههای خارجی
- و بررسی انسانی
در نظر گرفته شوند.
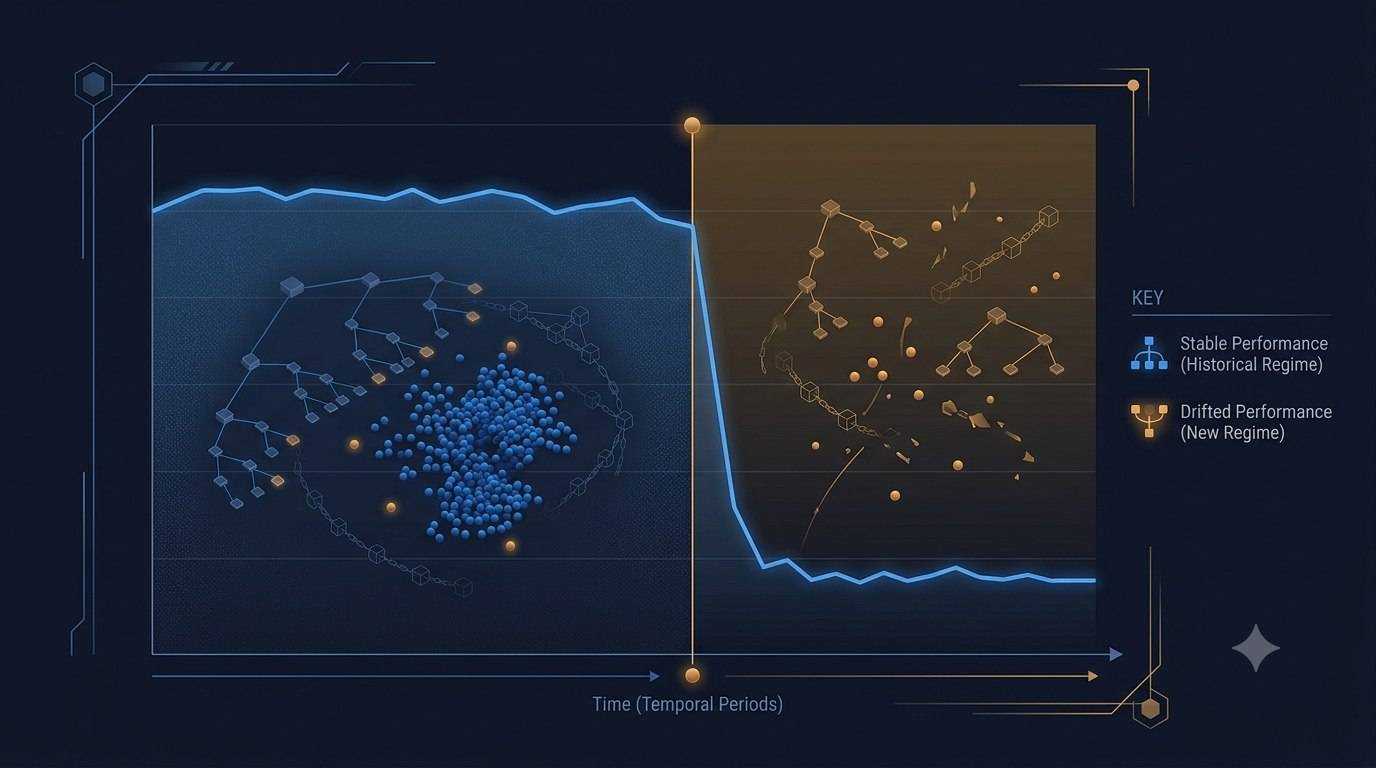
Concept Drift؛ وقتی رفتار داده تغییر میکند
یکی از مهمترین چالشهای کشف ناهنجاری در بلاکچین یادگیری ماشین در محیطهای پویا، Concept Drift است. فرض کنید یک مدل بر اساس دادههای چند ماه گذشته آموزش داده شده است. مدل یاد گرفته است که:
X → Y
یعنی مجموعه مشخصی از ویژگیها معمولاً با یک خروجی خاص همراه بودهاند. اما با گذشت زمان، رفتار سیستم تغییر میکند. ممکن است:
P(X) تغییر کند؛
یا حتی رابطه:
P(Y|X)
تغییر کند. در این حالت، مدل با دادهای مواجه میشود که با شرایط آموزشی آن تفاوت دارد.
انواع تغییر در توزیع داده
برای درک بهتر Concept Drift، باید میان چند نوع تغییر تمایز قائل شد.
Covariate Shift
Prior Probability Shift
در این وضعیت نسبت کلاسها تغییر میکند.
برای مثال، تعداد نمونههای مثبت نسبت به نمونههای منفی افزایش یا کاهش مییابد.
Concept Drift
در این حالت توزیع ویژگیهای ورودی تغییر میکند: P(X) تغییر میکند.
این حالت برای سامانههای تشخیص رفتار بسیار مهم است، زیرا ممکن است یک الگوی رفتاری که در گذشته با فعالیت مشروع همراه بوده، در شرایط جدید معنای متفاوتی پیدا کند.
دیتاست Elliptic و مطالعه رفتار زمانی
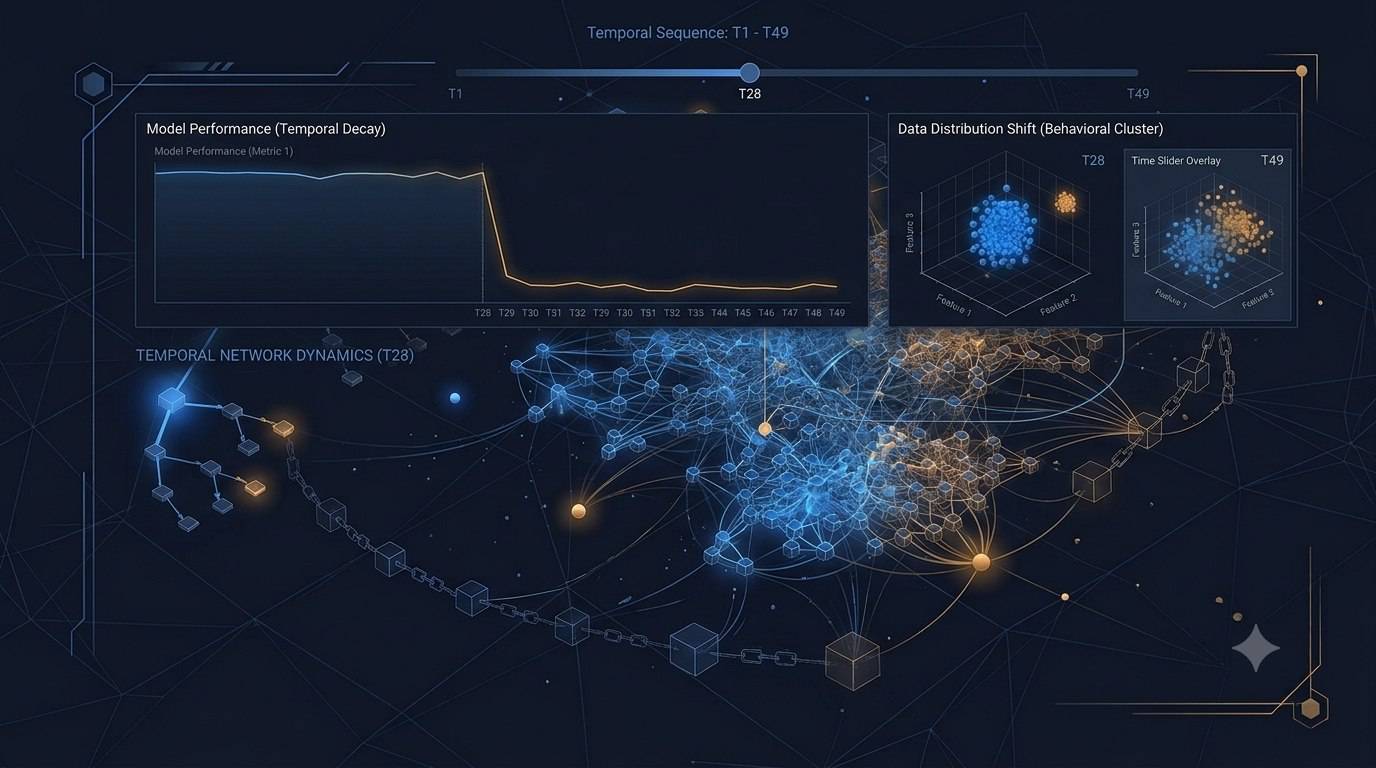
دیتاست Elliptic یکی از مجموعهدادههای شناختهشده در پژوهشهای مربوط به تشخیص تراکنشهای غیرقانونی در شبکه بیتکوین است. یکی از ویژگیهای مهم آن وجود ساختار زمانی است. دادهها در ۴۹ گام زمانی سازماندهی شدهاند و همین موضوع امکان بررسی عملکرد مدل در طول زمان را فراهم میکند. این ویژگی برای مطالعه Concept Drift بسیار ارزشمند است؛ زیرا بهجای آنکه تنها بپرسیم:
«مدل چقدر دقیق است؟»
میتوانیم سؤال مهمتری در کشف ناهنجاری در بلاکچین مطرح کنیم:
«مدل در طول زمان چقدر پایدار باقی میماند؟»
آزمایش زمانی و افت شدید Recall
در آزمایش مورد بررسی برای کشف ناهنجاری در بلاکچین، مدل Random Forest روی بخش ابتدایی دادههای زمانی آموزش داده شد و سپس در گامهای بعدی مورد ارزیابی قرار گرفت.
نتایج به یک الگوی قابل توجه اشاره میکردند:
- در گامهای اولیه، Recall در محدوده حدود ۸۰ درصد قرار داشت.
- در گامهای میانی عملکرد کاهش محدودی داشت.
- در گام زمانی ۴۲، Recall بهشدت سقوط کرد و به کمتر از حدود ۸ درصد رسید.
این نتیجه از منظر علم داده اهمیت زیادی دارد. اگر مدلی در داده آموزشی عملکرد بسیار خوبی داشته باشد، اما در یک دوره زمانی جدید بخش بزرگی از نمونههای مثبت را از دست بدهد، صرفاً گزارش یک F1 یا ROC-AUC کلی نمیتواند این مشکل را آشکار کند. به همین دلیل، Temporal Evaluation باید در مدلهای مورد استفاده برای دادههای پویا جدی گرفته شود.
ارتباط افت مدل با تغییرات محیطی
در تحلیل مورد بررسی، افت شدید عملکرد در حوالی یک نقطه زمانی خاص با رویدادی مرتبط با تعطیلی یک بازار تاریک همزمان مشاهده شده بود. این همزمانی از نظر پژوهشی جالب است؛ زیرا میتواند این فرضیه را مطرح کند که یک تغییر بزرگ در محیط تراکنشها باعث تغییر الگوهای رفتاری شده است.
با این حال، از نظر روششناسی باید احتیاط کرد. همزمانی دو رویداد بهتنهایی اثبات نمیکند که یکی علت مستقیم دیگری بوده است. برای اثبات رابطه علّی باید آزمایشهای بیشتری انجام شود. اما همین مشاهده میتواند یک هشدار مهم درباره ناپایداری مدل باشد.
چرا تغییر Threshold کافی نیست؟
وقتی Recall افت میکند، یکی از اولین راهکارهایی که ممکن است بررسی شود تغییر Decision Threshold است. برای مثال، میتوان آستانه را پایینتر آورد تا مدل نمونههای بیشتری را مثبت اعلام کند. اما این راهکار ممکن است باعث افزایش شدید False Positive شود.
در نتیجه:
Recall افزایش پیدا میکند، اما Precision کاهش مییابد.
اگر مشکل ناشی از تغییر واقعی توزیع داده باشد، تغییر Threshold تنها سطح تصمیمگیری را جابهجا میکند و مشکل اصلی را حل نمیکند. این موضوع نشان میدهد که Concept Drift صرفاً یک مشکل Threshold نیست. در برخی موارد، لازم است:
- مدل مجدداً آموزش داده شود؛
- ویژگیهای جدید تعریف شوند؛
- دادههای جدید وارد آموزش شوند؛
- یا از مدلهای تطبیقپذیر استفاده شود.
تحلیل گراف؛ نگاه کردن به شبکه بهجای یک تراکنش
یکی از مهمترین ویژگیهای بلاکچین، ساختار شبکهای آن است. میتوان شبکه را به شکل:
G = (V, E, W)
نمایش داد.
در این مدل:
- V مجموعه گرهها یا آدرسهاست.
- E مجموعه ارتباطات یا تراکنشهاست.
- W میتواند وزن تراکنش، مقدار انتقال یا ویژگی دیگری باشد.
در چنین ساختاری، هر تراکنش بخشی از یک شبکه بزرگتر است. این مسئله تفاوت اساسی میان تحلیل تراکنش و تحلیل گراف را نشان میدهد.
In-Degree و Out-Degree
یکی از سادهترین ویژگیهای گرافی، Degree است.
In-Degree
تعداد ارتباطات ورودی به یک گره را نشان میدهد.
Out-Degree
تعداد ارتباطات خروجی از یک گره را نشان میدهد.
آدرسی با Out-Degree بسیار بالا ممکن است نقش یک توزیعکننده، سرویس مالی، قرارداد هوشمند یا واسطه را داشته باشد. بنابراین Degree بهتنهایی نمیتواند رفتار مجرمانه را تعیین کند، اما میتواند یک ویژگی مهم برای مدل باشد.
Fan Ratio
یکی از معیارهای ساده قابل استخراج از Degreeها، Fan Ratio است:
Fan Ratio = Out-Degree / (In-Degree + ε)
اگر یک آدرس تعداد زیادی خروجی نسبت به ورودیهای خود داشته باشد، ممکن است ساختار رفتاری خاصی داشته باشد. اما باز هم باید تأکید کرد که این ویژگی تنها یک سیگنال است. برای مثال، یک صرافی یا سرویس پرداخت ممکن است بهصورت کاملاً مشروع Fan Ratio بالایی داشته باشد. بنابراین ویژگی گرافی باید در کنار سایر ویژگیها تفسیر شود.
Clustering Coefficient
Clustering Coefficient میزان اتصال ساختار محلی اطراف یک گره را اندازهگیری میکند. در تحلیل شبکههای مالی، ویژگیهای محلی میتوانند برای بررسی ساختار ارتباطی آدرسها مفید باشند. ترکیب Clustering با Degree، Centrality و ویژگیهای زمانی میتواند تصویر کاملتری از جایگاه یک آدرس در شبکه ایجاد کند.
مقایسه رویکردهای مختلف در دیتاست Elliptic
در آزمایش مورد بررسی، چند روش مختلف از نظر عملکرد طبقهبندی مقایسه شدند:
این جدول چند نکته مهم دارد. نخست اینکه افزودن ویژگیهای گرافی لزوماً عملکرد را افزایش نمیدهد. دوم اینکه یک مدل سادهتر مانند Random Forest میتواند در یک سناریوی مشخص عملکرد بسیار مناسبی داشته باشد. سوم اینکه نتیجه بسیار خوب یک مدل Oracle را نمیتوان بدون توجه به نحوه دسترسی به اطلاعات، به محیط واقعی منتقل کرد. این مسئله یک اصل مهم در علم داده را نشان میدهد:
عملکرد آزمایشگاهی با قابلیت استفاده عملی یکسان نیست.
چرا مدلهای گرافی همیشه بهتر نیستند؟
ماهیت شبکهای بلاکچین ممکن است این تصور را ایجاد کند که Graph Neural Networks همیشه باید بهترین عملکرد را داشته باشند. اما چنین نتیجهای از نظر علمی قابل تعمیم نیست.
مدلهای گرافی معمولاً پیچیدگی بیشتری دارند و به عواملی مانند:
- کیفیت گراف
- ساختار همسایگی
- حجم داده
- زمانبندی تراکنشها
- برچسبهای آموزشی
- منابع محاسباتی
وابستهاند.
همچنین در برخی معماریهای گرافی، مسئله Over-Smoothing میتواند باعث شود اطلاعات گرهها در لایههای متعدد بیش از حد مخلوط شود. بنابراین مدل مناسب باید بر اساس شواهد تجربی انتخاب شود، نه صرفاً به دلیل جدیدتر یا پیچیدهتر بودن.
ترکیب Machine Learning و Graph Analysis
یکی از مسیرهای جذاب، استفاده همزمان از ویژگیهای تراکنشی و ویژگیهای گرافی است.
برای مثال، یک آدرس میتواند ویژگیهایی مانند:
Transaction Features
- Amount
- Gas
- Time Delta
و همزمان:
Graph Features
- In-Degree
- Out-Degree
- Centrality
- Clustering
داشته باشد.
سپس این ویژگیها میتوانند در یک مدل ترکیبی استفاده شوند. مزیت چنین رویکردی این است که مدل فقط نمیپرسد:
«این تراکنش چه ویژگیهایی دارد؟»
بلکه میپرسد:
«این تراکنش در چه ساختار شبکهای رخ داده است؟»
اهمیت تحلیل زمانی و گرافی بهصورت همزمان
یکی از محدودیتهای تحلیل گراف ایستا این است که گراف را در یک لحظه خاص مشاهده میکند. اما شبکه بلاکچین دائماً در حال تغییر است. یک آدرس ممکن است امروز با ده آدرس ارتباط داشته باشد و فردا با هزار آدرس دیگر. بنابراین آینده تحلیل بلاکچین به سمت Temporal Graph Analysis حرکت میکند.
در این رویکرد، مدل تلاش میکند همزمان سه سؤال را پاسخ دهد:
- این آدرس با چه کسانی ارتباط دارد؟
- ساختار ارتباطات آن چگونه است؟
- این ساختار در طول زمان چگونه تغییر کرده است؟
این همان حوزهای است که مدلهایی مانند Temporal Graph Networks میتوانند مورد بررسی قرار گیرند.
محدودیتهای نمونه اولیه و تفاوت آن با محصول عملیاتی
یکی از اصول مهم در ارائه نتایج علمی، تفکیک میان Proof of Concept و Production System است.
یک نمونه اولیه میتواند نشان دهد که یک ایده از نظر فنی امکانپذیر است.
اما این موضوع به معنای آماده بودن آن برای استفاده عملیاتی در مقیاس بزرگ نیست.
در نسخه اولیه چنین پروژههایی، محدودیتهایی وجود دارد که باید صریحاً بیان شوند.
محدودیت دادههای Synthetic
اگر بخشی از آزمایشها با دادههای مصنوعی یا شبیهسازیشده انجام شوند، باید با احتیاط درباره تعمیم نتایج صحبت کرد.
داده واقعی میتواند شامل:
- نویز
- Missing Data
- رفتارهای غیرمنتظره
- تغییرات بازار
- تراکنشهای پیچیده قرارداد هوشمند
- و ساختارهای ناشناخته
باشد.
بنابراین عملکرد مدل روی داده Synthetic بهتنهایی عملکرد آن روی شبکه اصلی را تضمین نمیکند.
اتصال به دادههای Real-Time
برای ساخت یک سامانه عملیاتی، باید دادهها مستقیماً از زیرساختهای واقعی شبکه دریافت شوند. در چنین معماریای، جریان داده میتواند بهصورت مفهومی چنین باشد:
Blockchain Node
↓
WebSocket / RPC
↓
Streaming Pipeline
↓
Feature Engineering
↓
Risk Detection
↓
Alerting
این معماری نیازمند توجه به Latency، مدیریت خطا، ذخیرهسازی، مقیاسپذیری و قابلیت اطمینان است.
چالش Cross-Chain Analytics
یکی دیگر از چالشهای مهم، انتقال دارایی میان شبکههای مختلف است. اگر تحلیل تنها روی یک Blockchain انجام شود، بخشی از مسیر دارایی ممکن است خارج از دید باقی بماند.
Bridgeها، DEXها و سرویسهای انتقال بینزنجیرهای میتوانند ساختار مسیر حرکت دارایی را پیچیدهتر کنند. بنابراین یک سامانه پیشرفته در آینده باید بتواند:
Multi-Chain Transaction Intelligence
را نیز در نظر بگیرد.
نقشه راه توسعه سامانه
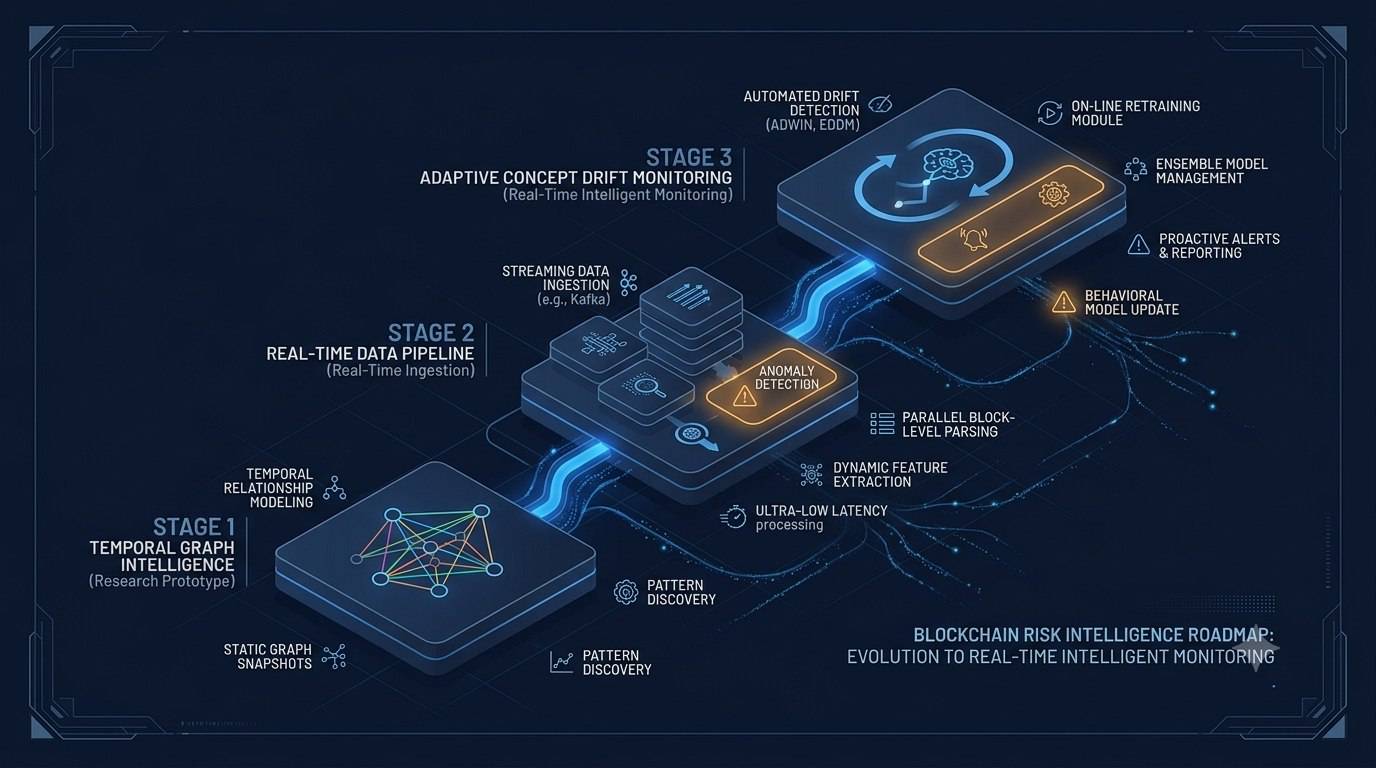
بر اساس چالشهای شناساییشده، مسیر توسعه را میتوان در سه فاز اصلی تعریف کرد.
فاز اول: Temporal Graph Intelligence
هدف این مرحله، ترکیب اطلاعات گرافی با زمان است.
مدلهایی مانند:
- TGN
- GAT
- Temporal GNN
میتوانند برای بررسی این مسیر مورد مطالعه قرار گیرند.
فاز دوم: Real-Time Data Pipeline
در این مرحله، سامانه از یک محیط پژوهشی به سمت معماری عملیاتی حرکت میکند.
یک معماری احتمالی:
RPC / WebSocket → Streaming → Feature Store → ML → Risk Engine → Alert
است.
فناوریهایی مانند FastAPI و Kafka میتوانند بسته به نیاز معماری در این مسیر بررسی شوند.
فاز سوم: Adaptive Drift Monitoring
در این مرحله، سیستم علاوه بر تراکنشها، عملکرد مدل را نیز پایش میکند.
روشهایی مانند:
- CUSUM
- Page-Hinkley
- Online Learning
- Adaptive Retraining
- Drift Detection
میتوانند برای این هدف مورد بررسی قرار گیرند.
معماری پیشنهادی برای سامانه هوشمند
با جمعبندی مباحث مطرحشده، میتوان معماری مفهومی زیر را برای یک سامانه پیشرفته در نظر گرفت:
مرحله اول: Data Ingestion
دریافت تراکنشها از شبکه و منابع داده.
مرحله دوم: Data Validation
بررسی کیفیت، کامل بودن و سازگاری دادهها.
مرحله سوم: Feature Engineering
ساخت ویژگیهای مالی، زمانی و گرافی.
مرحله چهارم: Rule Engine
اجرای قوانین مشخص و تفسیرپذیر.
مرحله پنجم: Machine Learning
محاسبه Anomaly Score و شناسایی رفتارهای غیرمعمول.
مرحله ششم: Graph Intelligence
بررسی روابط میان آدرسها.
مرحله هفتم: Temporal Intelligence
بررسی تغییر رفتار در طول زمان.
مرحله هشتم: Risk Scoring
ترکیب سیگنالهای مختلف.
مرحله نهم: Drift Monitoring
بررسی تغییر رفتار داده و افت عملکرد مدل.
مرحله دهم: Alerting & Reporting
ارائه هشدار و گزارش قابل بررسی.
چرا Explainability اهمیت دارد؟
در یک سامانه ریسک، تنها ارائه یک عدد کافی نیست. اگر سیستم اعلام کند:
Risk Score = 0.91
کاربر باید بتواند بفهمد این عدد چگونه تولید شده است.
برای مثال:
- حجم تراکنش غیرعادی بوده است.
- تعداد گیرندگان در یک بازه کوتاه افزایش یافته است.
- ارتباط با یک خوشه پرریسک مشاهده شده است.
- فاصله زمانی تراکنشها غیرعادی بوده است.
- Anomaly Score بالا بوده است.
چنین ساختاری امکان Explainable Risk Assessment را افزایش میدهد.
تفاوت تشخیص ناهنجاری با تشخیص جرم
این تفاوت باید در کشف ناهنجاری در بلاکچین تمام سامانههای هوشمند جدی گرفته شود. Anomaly Detectionیک مسئله آماری و محاسباتی است. اما Crime Detection یک مفهوم حقوقی و زمینهای است. مدل یادگیری ماشین نمیتواند صرفاً بر اساس فاصله یک نقطه از توزیع آماری، جرم را اثبات کند. به همین دلیل بهتر است خروجی سامانه به شکل:
Anomaly Signal
یا
Risk Signal
تعریف شود. سپس بررسی تکمیلی بر اساس دادههای بیشتر انجام شود. این تفکیک، هم از نظر علمی و هم از نظر طراحی سامانه اهمیت اساسی دارد.
نقش علم داده در آینده تحلیل بلاکچین
علم داده در این حوزه صرفاً به معنای استفاده از یک الگوریتم یادگیری ماشین نیست. یک سامانه حرفهای برای کشف ناهنجاری در بلاکچین نیازمند مجموعهای از فعالیتهاست:
Data Collection
→
Data Cleaning
→
Statistical Analysis
→
Feature Engineering
→
Machine Learning
→
Graph Analytics
→
Temporal Modeling
→
Model Evaluation
→
Drift Monitoring
→
Continuous Improvement این زنجیره نشان میدهد که تحلیل بلاکچین یک مسئله چندرشتهای است.
نتیجهگیری
کشف ناهنجاری و تشخیص تراکنشهای مشکوک در بلاکچین، مسئلهای فراتر از اجرای یک الگوریتم طبقهبندی است. ماهیت شبهناشناس دادهها، عدم توازن کلاسها، رفتارهای نادر، توزیعهای نامتقارن، وابستگی زمانی و ساختار گرافی تراکنشها باعث میشوند طراحی یک سامانه مؤثر به ترکیب چند روش نیاز داشته باشد.
موتورهای Rule-Based میتوانند الگوهای شناختهشده را با سرعت و قابلیت توضیح مناسب شناسایی کنند. در کشف ناهنجاری در بلاکچین روشهای بدون نظارت مانند Isolation Forest میتوانند رفتارهایی را که از الگوی معمول داده فاصله دارند شناسایی کنند. تحلیل گراف نیز امکان بررسی روابط میان آدرسها و شناسایی ساختارهایی را فراهم میکند که در تحلیل مستقل تراکنشها قابل مشاهده نیستند. با این حال، یکی از مهمترین نتایج تحلیل دادههای زمانی آن است که عملکرد مدل در طول زمان ثابت نیست.
آزمایشهای انجامشده روی دیتاست Elliptic و مشاهده افت شدید Recall در یک گام زمانی خاص، نمونهای مهم از این مسئله را نشان میدهد. مدلی که در یک بازه زمانی عملکرد مناسبی دارد ممکن است در مواجهه با تغییر ساختاری داده، بخش قابل توجهی از نمونههای موردنظر را از دست بدهد. بنابراین در سامانههای واقعی، ارزیابی مدل نباید تنها بر اساس یک عدد کلی مانند Accuracy یا F1-Score انجام شود. مدل باید در طول زمان، روی دادههای جدید و در شرایط مختلف ارزیابی شود.
از سوی دیگر، پیچیدهتر بودن مدل نیز الزاماً به معنای عملکرد بهتر نیست. نتایج تجربی مورد بررسی نشان دادند که یک مدل نسبتاً ساده مانند Random Forest میتواند در یک سناریوی مشخص از برخی رویکردهای گرافی پیچیدهتر عملکرد بهتری داشته باشد. بنابراین انتخاب مدل باید بر اساس داده، مسئله، کیفیت ویژگیها، هزینه محاسبات، نیازهای Real-Time، قابلیت توضیحپذیری و پایداری زمانی انجام شود. مسیر آینده نیز به سمت ترکیب سه بعد اصلی حرکت میکند:
رفتار + ساختار شبکه + زمان
مدلهای Temporal Graph، سامانههای Real-Time، Online Learning و روشهای تشخیص Concept Drift میتوانند نسل بعدی معماریهای تحلیل ریسک بلاکچین را شکل دهند. در نهایت، هدف یک سامانه هوشمند نباید صرفاً این باشد که بگوید «این تراکنش خوب است یا بد».
هدف واقعیتر این است که بتواند:
رفتار غیرمعمول را شناسایی کند، زمینه آن را تحلیل کند، ارتباطات شبکهای را بررسی کند، تغییرات زمانی را تشخیص دهد و شواهد قابل تفسیر برای ارزیابی ریسک ارائه کند. این نگاه، علم داده را از یک ابزار صرفاً پیشبینیکننده به بخشی از یک سامانه هوشمند تحلیل و پایش ریسک تبدیل میکند.
سؤالات متداول
کشف ناهنجاری در بلاکچین چیست؟
کشف ناهنجاری یا Anomaly Detection فرایندی برای شناسایی تراکنشها یا رفتارهایی است که نسبت به الگوی معمول دادهها غیرعادی به نظر میرسند. این روش یکی از ابزارهای مهم برای ایجاد سیگنال ریسک در تحلیل تراکنشهای بلاکچینی است.
آیا هر تراکنش غیرعادی یک تراکنش مجرمانه است؟
خیر. ناهنجاری آماری الزاماً به معنای جرم یا فعالیت غیرقانونی نیست. یک تراکنش ممکن است از نظر آماری بسیار متفاوت باشد اما دلیل کاملاً مشروعی داشته باشد. به همین دلیل خروجی مدل باید بهعنوان سیگنال ریسک و نه اثبات جرم تفسیر شود.
Isolation Forest چگونه در بلاکچین استفاده میشود؟
Isolation Forest میتواند ویژگیهایی مانند حجم انتقال، Gas، فاصله زمانی تراکنشها و برخی ویژگیهای رفتاری را بررسی کند و نمونههایی را که نسبت به الگوی کلی داده غیرعادیتر هستند شناسایی کند.
Concept Drift چیست؟
Concept Drift زمانی رخ میدهد که الگو یا رابطه آماری میان دادههای ورودی و خروجی در طول زمان تغییر کند. در این شرایط، مدل آموزشدیده با دادههای گذشته ممکن است در تشخیص الگوهای جدید عملکرد خود را از دست بدهد.
چرا Recall در تشخیص تراکنشهای مشکوک اهمیت دارد؟
Recall نشان میدهد مدل چه نسبتی از نمونههای مثبت واقعی را شناسایی کرده است. کاهش شدید Recall میتواند به معنای از دست رفتن تعداد زیادی از موارد مهم باشد.
دیتاست Elliptic چه کاربردی دارد؟
Elliptic یک دیتاست پژوهشی شناختهشده برای بررسی تراکنشهای بیتکوین و مطالعه طبقهبندی رفتارهای مشروع و غیرقانونی است. ساختار زمانی آن نیز امکان مطالعه عملکرد مدل در طول زمان را فراهم میکند.
تحلیل گراف چه مزیتی نسبت به تحلیل یک تراکنش دارد؟
تحلیل گراف روابط میان آدرسها و تراکنشها را بررسی میکند. این روش میتواند ساختارهایی مانند Fan-In، Fan-Out، گرههای واسط و الگوهای ارتباطی پیچیده را آشکار کند.
آیا Graph Neural Network همیشه بهترین الگوریتم برای بلاکچین است؟
خیر. عملکرد مدل به داده، ویژگیها، کیفیت گراف، منابع محاسباتی و شرایط آزمایش بستگی دارد. در برخی سناریوها، مدلهای سادهتر مانند Random Forest میتوانند عملکرد مناسبی داشته باشند.
نظری دارید؟
واکنشتان را به اشتراک بگذارید یا یک پاسخ سریع بگذارید — دوست داریم نظر شما را بشنویم!
-
 0
- 0
- 0
- 0
- 0
- 0


